


핵심 요약
Qwen3.5-Omni는 텍스트, 이미지, 오디오, 영상까지 한 모델에서 이해하고 생성하는 Qwen의 최신 옴니모달 모델이다.
이 모델은 오프라인 분석 성능과 실시간 대화 능력을 함께 강화했으며, 특히 음성 인식·음성 생성·오디오비주얼 이해에서 큰 폭의 향상을 보였다.
핵심 변화는 더 긴 컨텍스트, 더 넓은 다국어 지원, 실시간 음성 상호작용, 그리고 ARIA 기반의 안정적인 음성 출력이다.
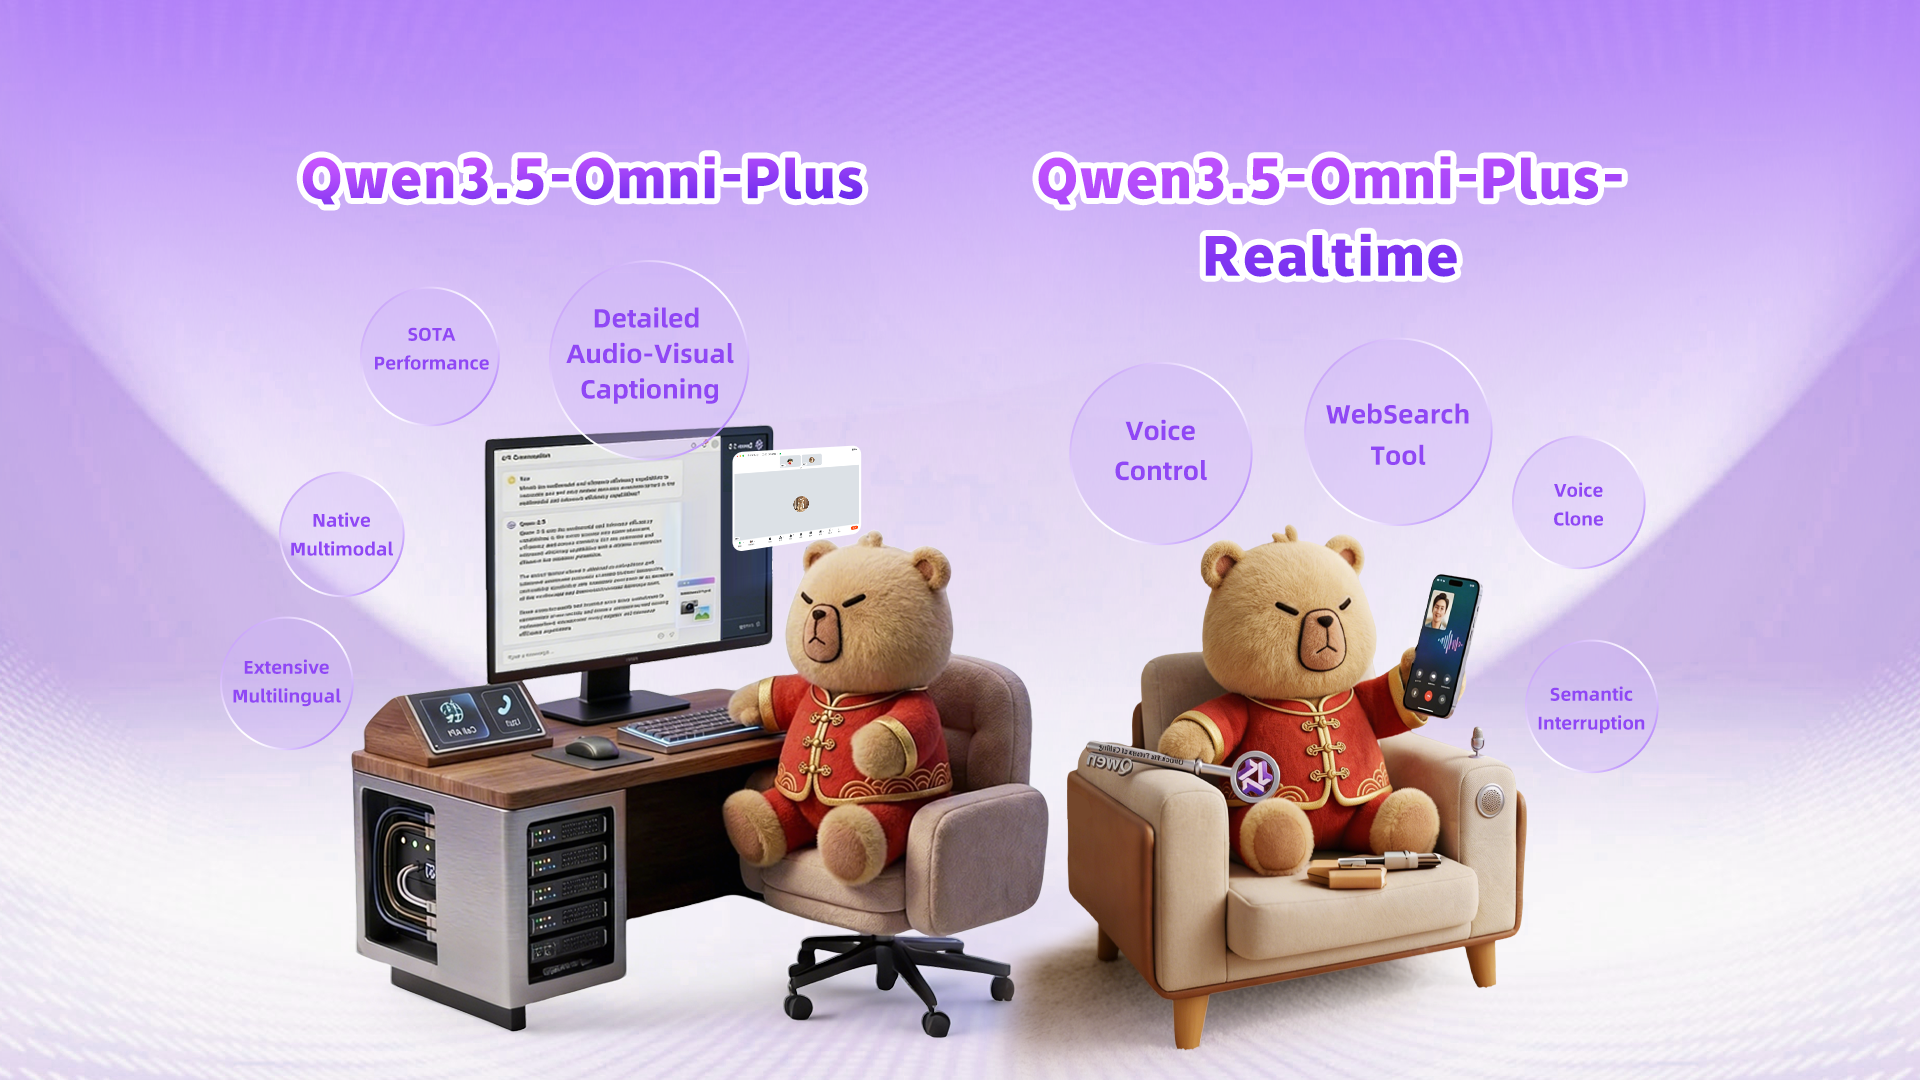
Qwen3.5-Omni는 무엇인가
Qwen3.5-Omni는 단순히 "멀티모달 입력을 받는 LLM"보다 한 단계 더 나아간다.
텍스트, 이미지, 오디오, 영상 정보를 함께 다루고, 그 결과를 텍스트나 음성으로 자연스럽게 내놓는 구조를 갖는다.
쉽게 말해, 눈과 귀로 동시에 이해하고, 입으로 답하는 모델에 가깝다.
제품군은 Plus, Flash, Light로 나뉘며, 최대 256k 컨텍스트를 지원한다.
긴 오디오도 다룰 수 있어서 10시간이 넘는 음성 입력과 수백 초 길이의 오디오 포함 영상을 처리할 수 있다.
구조의 핵심: Thinker와 Talker
모델은 크게 Thinker와 Talker로 나뉜다.
Thinker는 보고 듣고 읽은 정보를 종합해 의미를 이해하고, Talker는 그 결과를 맥락에 맞는 음성으로 만들어낸다.
이 분리는 사람으로 비유하면 "생각하는 뇌"와 "말하는 입"을 나눈 셈이다.
Thinker와 Talker 모두 Hybrid-Attention MoE를 사용한다.
오디오와 비주얼 정보는 시간축과 위치 정보를 반영해 함께 인코딩되고, 음성 생성은 더 가벼운 표현 방식으로 처리되어 실시간 응답에 유리하다.
Qwen3-Omni에서 무엇이 달라졌나
이전 세대와 비교하면 가장 큰 변화는 범용성보다 실사용성의 강화다.
컨텍스트 길이는 32k에서 256k로 커졌고, 오디오는 10시간 이상, 영상은 1FPS 기준 400초 이상까지 다룰 수 있다.
또한 이전에는 없던 기능들이 대거 추가됐다.
의미 기반 끼어들기 판단, WebSearch와 함수 호출, 음성 스타일 제어, 음성 복제, 오디오비주얼 캡셔닝이 대표적이다.
즉, "잘 이해하는 모델"에서 "실시간으로 상호작용하는 조수"에 가까워졌다.
오프라인 성능의 강점
Qwen3.5-Omni-Plus는 오디오와 오디오비주얼 평가에서 매우 강한 성능을 보인다.
문서에서는 215개 세부 과제와 벤치마크에서 최고 수준 결과를 냈다고 설명한다.
특히 일반 오디오 이해, 음성 인식, 음성 번역, 대화 능력에서 경쟁 모델과 맞서거나 앞서는 구간이 많다.
시각과 텍스트 능력도 같은 크기의 Qwen3.5 계열과 비슷한 수준을 유지한다.
즉, 오디오 능력을 강화했다고 해서 텍스트나 비전 성능을 희생한 구조는 아니라는 점이 핵심이다.
실시간 대화에서 중요한 기능들
실시간 사용에서는 단순히 빨리 말하는 것보다 "언제 말하고 언제 멈출지"가 더 중요하다.
Qwen3.5-Omni는 의미 기반 interruption을 지원해, 사용자의 진짜 발화 의도와 잡음·맞장구를 구별하려고 한다.
덕분에 배경 소리나 짧은 끄덕임 때문에 대화가 자주 끊기는 문제를 줄인다.
또한 WebSearch와 Function Call을 기본적으로 활용할 수 있어, 필요한 경우 스스로 외부 도구를 호출해 답을 보강한다.
여기에 말투, 속도, 감정, 볼륨까지 제어할 수 있어 음성 비서다운 활용성이 커졌다.
ARIA가 중요한 이유
실시간 음성 대화에서 자주 생기는 문제는 텍스트와 음성 토큰의 속도가 다르다는 점이다.
이 차이 때문에 숫자를 잘못 읽거나, 일부 단어를 빠뜨리거나, 발음이 흐려질 수 있다.
Qwen3.5-Omni는 이를 해결하기 위해 ARIA를 도입했다.
ARIA는 텍스트 단위와 음성 단위를 동적으로 맞춰 섞는 방식이다.
비유하면 악보와 연주의 박자를 실시간으로 맞추는 지휘자 같은 역할을 한다.
결과적으로 자연스러움과 안정성이 좋아지고, 스트리밍 중 읽기 오류도 줄어든다.
다국어 음성 능력의 확대
다국어 지원 폭은 이번 세대의 가장 눈에 띄는 변화 중 하나다.
음성 인식은 113개 언어·방언까지, 음성 생성은 36개 언어·방언까지 확장됐다.
이전 세대보다 지원 범위가 크게 넓어졌고, 중국어 방언도 훨씬 다양해졌다.
이건 단순한 언어 수 늘리기가 아니다.
글로벌 서비스, 콜센터, 지역 맞춤형 AI 비서처럼 실제 배포 환경에서 중요한 경쟁력이 된다.
특히 음성 복제까지 결합되면 "같은 목소리로 여러 언어를 말하는 비서" 같은 사용 사례가 가능해진다.
돋보이는 활용처: 오디오비주얼 캡셔닝과 Vibe Coding
문서에서 특히 강조한 기능은 오디오비주얼 캡셔닝이다.
영상 장면, 소리, 화자, 자막 요소를 시간축에 따라 세밀하게 설명하고, 구조화된 결과로 정리할 수 있다.
예를 들어 다큐 영상에서는 장면 전환, 배경음, 내레이션, 화면 텍스트를 시간별로 풀어낼 수 있고, 영화 예고편에서는 등장인물·대사·효과음·테마를 함께 분석할 수 있다.
또 하나 흥미로운 점은 Audio-Visual Vibe Coding이다.
오디오비주얼 지시를 바탕으로 직접 코딩을 수행하는 능력이 나타났다고 설명한다.
즉, "이 영상 속 UI처럼 만들어줘"나 "이 동작 흐름을 게임으로 구현해줘" 같은 형태의 창작 보조가 가능해지는 방향이다.
데모가 보여준 실제 사용 방식
데모들은 모델의 강점을 아주 실용적으로 보여준다.
자연 다큐 영상 분석에서는 장면 설명, 화면 문구 추출, 화자 프로필, 타임스탬프 기반 대본 정리를 동시에 수행한다.
영화 예고편 분석에서는 시각적 장면, 음향 설계, 등장인물의 말투와 역할까지 구조적으로 정리한다.
또 짧은 일상 영상에서는 춤, 군중 반응, 현장음, 문화적 맥락까지 함께 해석한다.
이건 단순 요약이 아니라, "영상 보고 리포트 쓰기"를 자동화하는 능력에 가깝다.
실무에서 어떻게 쓰면 좋은가
짧고 단순한 작업이면 저해상도·짧은 프롬프트로 비용을 아끼는 방식이 적합하다.
긴 영상의 거친 분할이나 1차 검수도 이런 모드가 잘 맞는다.
반대로 화자 구분, 자막 추출, 장면별 분석처럼 정밀한 작업은 구조화 프롬프트와 더 높은 입력 품질이 유리하다.
긴 영상은 한 번에 모두 넣기보다 구간별로 나누는 것이 좋다.
특히 오디오가 중요한 영상은 구간 분할 후 같은 템플릿으로 반복 분석하면 품질과 일관성을 함께 챙길 수 있다.
인사이트
Qwen3.5-Omni의 핵심은 "모든 모달을 받는다"가 아니라, 그것들을 실제 상호작용과 생산성 도구로 연결했다는 데 있다.
학습용으로 보면 세 가지를 기억하면 된다. 첫째, Thinker-Talker 분리 구조. 둘째, ARIA 기반 실시간 음성 안정화. 셋째, 오디오비주얼 분석과 음성 대화의 실용성이다.
활용할 때는 목적을 먼저 정하면 좋다. 긴 영상 분석인지, 실시간 음성 비서인지, 다국어 TTS인지에 따라 입력 길이, 프롬프트 구조, API 선택이 달라진다.
출처 및 참고 : Qwen
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.