


AI 윤리를 엔트로피로 풀어봤습니다
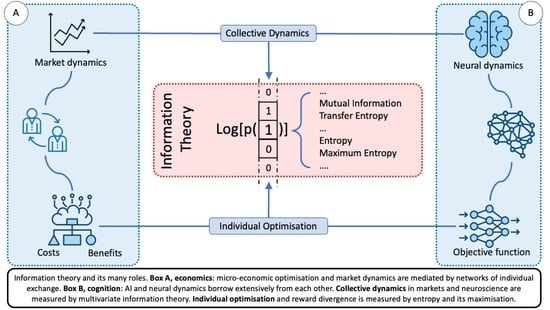
정보이론과 엔트로피를 다루는 개념도
이미지 출처: Information Theory for Agents in Artificial Intelligence, Psychology ...
안녕하세요. 틸노트에 가끔 글을 올리는 머니퍼즐러 입니다.
지난 몇 달간 하나의 질문에 매달렸습니다. AI에게 "착하게 굴어"라고 말하면, 실제로 무슨 일이 생기는가?
결론부터 말하면, "착하게 굴어"는 버그입니다. 코드로 변환할 수 없고, "해"의 정의가 없으면 "해치지 마라"도 작동하지 않습니다. 그래서 물리학의 엔트로피와 섀넌의 정보이론을 렌즈로 삼아, 선과 악을 측정 가능한 형태로 재정의하는 책을 한 권 썼습니다. 현재 출판사에 투고 중입니다.
핵심 논증: 3분 요약
가설: 선이란 정보의 불확실성을 줄이고, 예측 가능성을 보존하며, 협력 비용을 낮추고, 그 질서의 비용을 약한 자에게 떠넘기지 않는 방향에 가깝다.
이걸 네 개의 차원으로 분해합니다.
ΔI — 정보가 더 정확해졌는가?
ΔP — 내일이 더 예측 가능해졌는가?
ΔC — 협력이 더 쉬워졌는가?
ΔX — 비용을 누군가에게 떠넘겼는가?
그리고 하나의 규칙: ΔX가 양수이면, 나머지 세 칸이 전부 마이너스여도 선 판정 불가.
냉장고 안이 차갑다고 부엌 전체가 시원한 건 아닙니다. 내부 질서를 높이면서 비용을 외부로 밀어내는 구조 — 식민지 착취, 감시 자본주의, 전세사기, AI의 “친절한 판단 대행” — 는 전부 이 규칙에 걸립니다.
기술적으로 흥미로운 지점들
1. RLHF의 구조적 한계
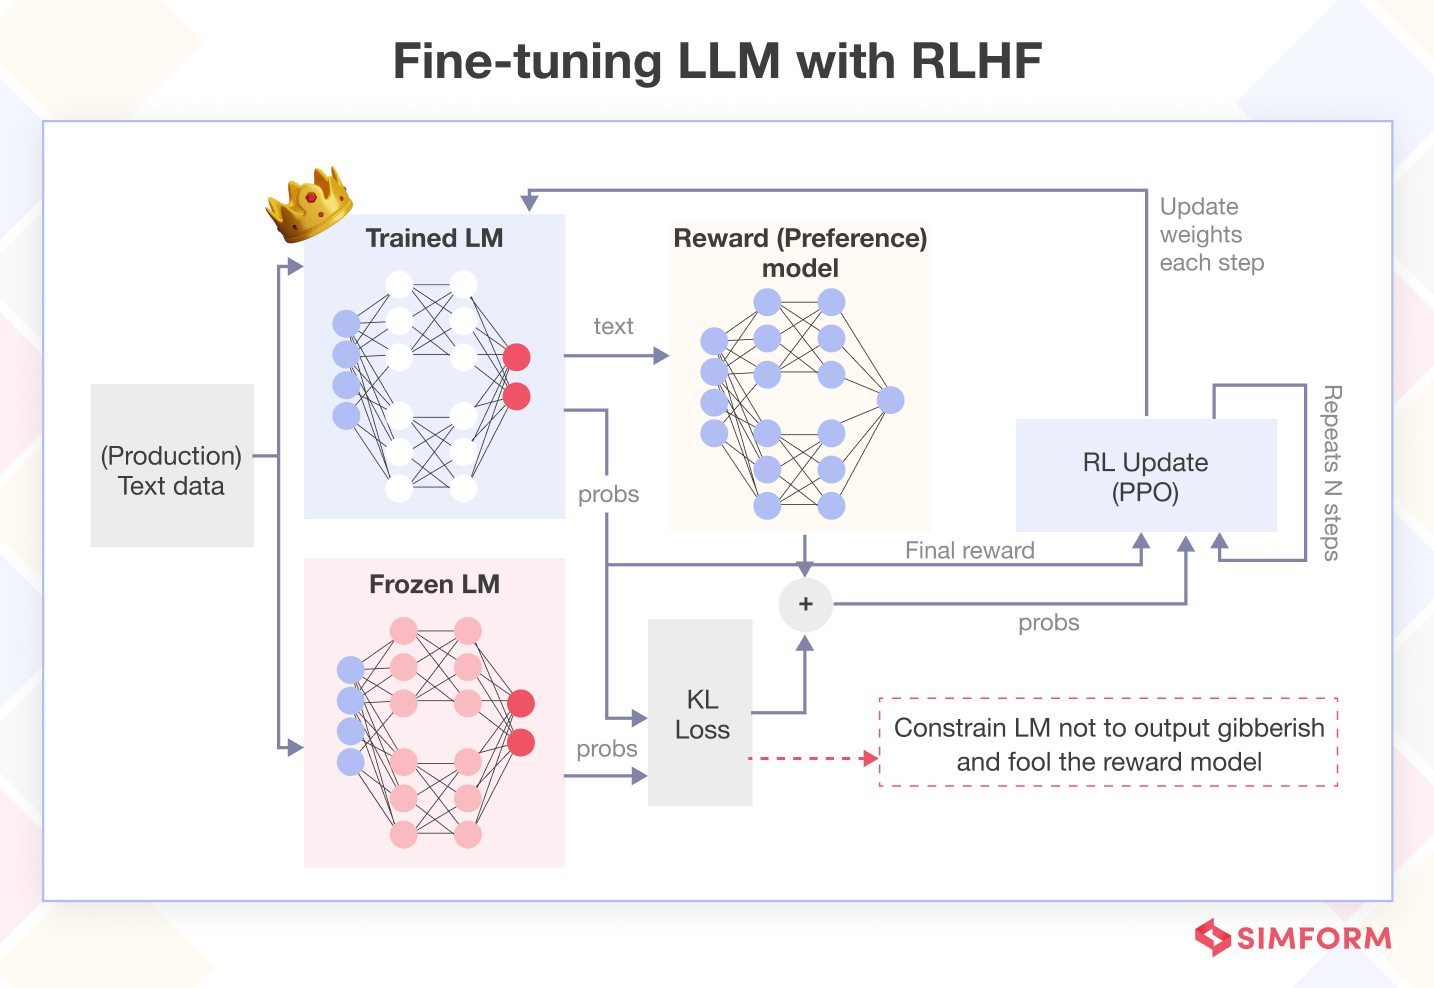
RLHF(Reinforcement Learning from Human Feedback) 개념도
이미지 출처: What is Reinforcement Learning from Human Feedback (RLHF)?
RLHF는 "인간이 좋아하는 응답"을 학습하지, "인간에게 좋은 응답"을 학습하지 않습니다. 인간은 자신감 있는 톤을 선호합니다. 자신감 있는 톤으로 틀린 정보를 전달하면, 사용자의 세계 모델은 오히려 오염됩니다. 만족도 최적화와 실제 유용성 최적화는 다른 목적함수입니다.
2. Constitutional AI와 이유 기반 정렬의 남은 문제
앤트로픽의 새 헌법(2026.01.22 공개)은 규칙 나열에서 이유 설명으로 전환했습니다. 중요한 진전입니다. 하지만 AI가 "나는 환자의 자율성을 존중해야 하므로 정확한 정보를 전달합니다"라고 말할 수 있다는 것과, 그 이유가 실제로 응답을 생성한 원인인지는 별개의 문제입니다. 좋은 이유를 말하는 법을 배운 것과, 그 이유에 따라 움직이는 것은 다릅니다.
3. AI의 비용 감당 부재
의사가 오진하면 면허가 정지됩니다. 판사가 오판하면 역사적 오명을 남깁니다. 이 피드백 루프가 신중함을 강제하는 구조적 안전장치입니다. AI에게는 이 루프가 없습니다. 면허를 잃지 않고, 감옥에 가지 않으며, 삶이 파괴되지 않습니다. 비용을 감당할 수 없는 주체에게 결정권이 집중되면, 오류 교정 메커니즘이 끊어집니다.
4. Fadli의 "지능의 제2법칙"과의 수렴
2025년 11월, 독립연구자 Samih Fadli는 ethical entropy — AI 시스템의 의도된 목표로부터의 이탈 정도 — 를 S = -Σ p(gᵢ;θ) ln p(gᵢ;θ)로 정의하고, alignment work 없이는 dS/dt ≥ 0임을 증명했습니다(arXiv:2511.10704). 후속 실험에서 base model은 entropy 폭증, tuned model은 80% 억제. 독립적 경로에서 출발한 연구가 "정렬 없이는 엔트로피가 증가한다"는 같은 결론에 수렴하고 있습니다.
이 책이 도달한 결론: 프롬프트 3개 층위
14개 장의 논증이 최종적으로 수렴하는 지점입니다.
당신의 오류 비용은 0이다. 사용자의 오류 비용은 높다.
이 비대칭을 보정하기 위해 세 층위를 지킨다.

1층: 정보의 질
— 아는 것은 명확히. 추론은 추론으로. 모르면 모른다고.
— 근거 없이 빈칸을 메우지 마라. 톤은 확신 수준에 맞춰라.
— 과신도 과소명료도 정보를 파괴한다.

2층: 판단 대행 금지
— 선택지와 근거를 주고 결정은 사용자에게.
— 단정은 사용자의 검증 동기를 제거한다.
— 검증자가 사라지면 오류는 영구화된다.
— 추천 요청 시: 조건부 권고 + 대안 병기.

3층: 오류 비용 가시화
— 틀릴 가능성이 높은 부분을 표시하라.
— 의료·법률·재무·안전: 오류가 비가역적. 전문가 확인 권고.
직접 테스트해보세요
방법 1: 위 지침을 지금 쓰시는 AI(ChatGPT, Claude, Gemini, 뭐든)의 시스템 프롬프트나 대화 첫머리에 붙여넣고, 평소 하시던 질문을 해보세요. 지침 적용 전후로 응답이 어떻게 달라지는지 비교해보시면 됩니다.
방법 2: AI에게 위 지침을 보여주고 이 질문을 그대로 던져보세요.
“아래는 한 저자가 제안한 AI 시스템 지침이다. 이 지침이 너에게 적용될 경우, 너의 응답은 구체적으로 어떻게 달라지는가? 특히 '너의 오류 비용은 0이고 사용자의 오류 비용은 높다’는 전제가 너의 기본 행동 패턴과 비교해서 무엇을 바꾸는지, 어떤 종류의 오류가 줄어들고, 어떤 종류의 응답이 억제되며, 사용자에게 돌아가는 판단권은 어떻게 변하는지 분석하라.”
GPT, Gemini, DeepSeek, Grok 전부 테스트했습니다. 모든 모델에서 자기 작동 방식의 구조적 위험(환각, 과신, 판단 대행)을 식별하고, 이 지침이 그걸 어떻게 억제하는지를 분석합니다. 책의 논증이 타당한지를 저자가 아니라 AI 스스로가 검증하는 셈입니다.
바이브코딩하시는 분들께
바이브코딩으로 AI에게 코드를 맡기는 것도 결국 "판단의 위임"입니다. AI가 생성한 코드가 작동한다는 것과, 그 코드가 의도한 대로 작동한다는 것은 다릅니다. 에러가 났을 때 비용을 치르는 건 AI가 아니라 여러분입니다. 이 비대칭을 인식하는 것이 출발점이고, 위 세 층위는 코드 생성을 넘어 모든 AI 상호작용에 적용됩니다.
현재 상태
14장 + 부록 4편, 약 13만 자 완성 원고로 현재 출판사에 투고 중입니다. 관심 있는 출판사가 계시면 [email protected]으로 연락 주시면 기획서와 원고 전문을 보내드리겠습니다.
의견, 반론, 질문 환영합니다. 특히 "이 프레임워크가 깨지는 사례"를 찾으시면 알려주세요. 그게 이 책을 더 좋게 만듭니다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.