

요즘 AI 글을 읽다 보면 분위기가 비슷합니다.
에이전트가 다 해주고, 프롬프트 몇 줄이면 자동화가 끝나고,
지금 안 하면 뒤처질 것처럼 보입니다.
그런데 실제로 AI 기능을 서비스에 붙여 보면,
진짜 문제는 모델이 잘 말하는 순간이 아니라 애매하게 틀릴 때 시스템이 어떻게 행동하느냐에 있습니다.
NIST의 생성형 AI 프로파일도 생성형 AI는 별도의 위험 관리, 측정, 운영 통제가 필요하다고 정리합니다. [NIST AI 600-1]
제가 실무에서 중요하다고 보는 건 세 가지입니다.
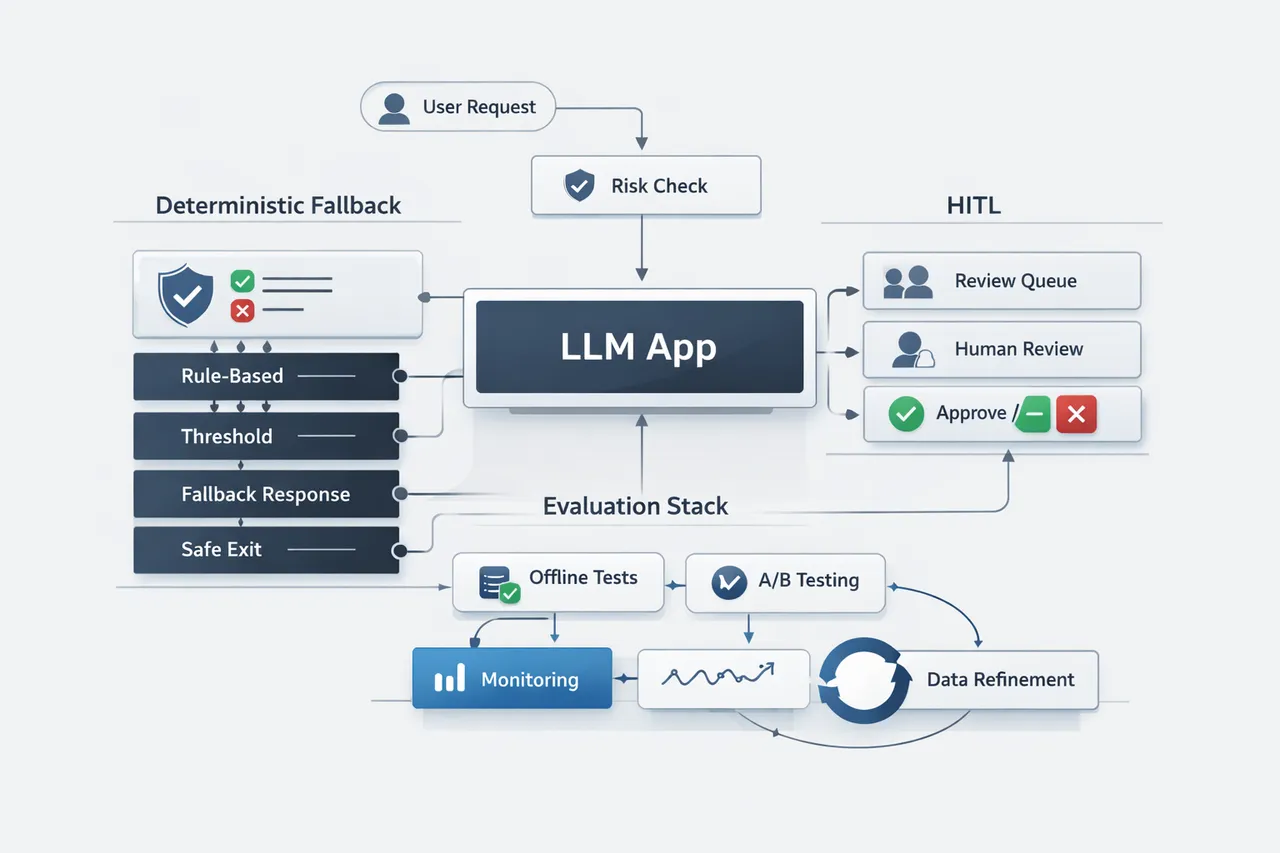
Deterministic Fallback
HITL(Human-in-the-Loop)
Evaluation Stack
이 셋은 모델을 더 똑똑하게 만드는 기술이라기보다,
모델이 흔들려도 제품이 같이 흔들리지 않게 만드는 설계에 가깝습니다.
Anthropic은 성공 기준을 먼저 정의하고 평가를 설계하라고 안내하고,
OpenAI도 생성형 시스템은
전통적인 테스트만으로 부족하므로 eval이 필요하다고 설명합니다.
[Anthropic: Define success] [OpenAI: Evaluation best practices]
먼저, 이런 사고부터 막아야 합니다
예를 들어 고객지원 AI가 환불 정책을 안내한다고 해봅시다.
사용자가 이렇게 묻습니다.
지난달 결제 건 환불 가능한가요? 카드 취소로 처리해 주세요.
모델은 아주 자연스럽게 이렇게 답할 수 있습니다.
네, 최근 30일 이내 결제 건은 자동 환불 가능합니다. 바로 진행할게요.
문제는 실제 정책엔 “디지털 상품 사용 이력이 있으면 환불 불가” 조항이 있고,
자동 환불은 상담사 승인 대상일 수 있다는 점입니다.
이때 사고의 본질은 “모델이 틀렸다”보다
시스템이 틀렸을 때 멈추도록 설계되지 않았다에 더 가깝습니다.
Anthropic도 환각을 줄이려면 제공된 문맥에 근거하도록 하고,
가능하면 인용과 검증 가능한 출처를 붙이라고 권합니다.
[Anthropic: Reduce hallucinations] [Anthropic: Citations]
1. Deterministic Fallback: 모르면 안전한 길로 내려간다
많은 개발자가 처음엔 temperature를 낮추고
프롬프트를 다듬으면 꽤 안정적일 거라고 생각합니다.
어느 정도는 맞습니다.
하지만 그건 출력 흔들림을 줄이는 쪽에 가깝지, 시스템 전체를 결정적으로 만드는 것과는 다릅니다.
OpenAI의 eval 가이드도 생성형 AI는 본질적으로 variability가 있기 때문에,
기존 소프트웨어 테스트만으로는 충분하지 않다고 설명합니다.
[OpenAI: Evaluation best practices]
그래서 실무에서 필요한 건 “모델을 완전히 결정론적으로 만들기”가 아니라,
모델이 애매하거나 실패했을 때 시스템이 미리 정한 경로로 강등되도록 만드는 것입니다.
이게 Deterministic Fallback입니다.
NIST는 생성형 AI 운영에서
정책 기반 통제, 구조화된 피드백, 단계적 출시 같은 관리 활동을 권고합니다. [NIST AI 600-1]
예를 들면 이런 사다리입니다.
정상 경로: 모델이 답을 만들고 검증도 통과한다
제한 경로: 답은 주되, 근거가 확인된 범위만 말한다
대체 경로: 생성 대신 검색 결과, 정책 문서, 템플릿만 보여준다
중단 경로: 사람 검토로 넘긴다
핵심은 간단합니다. 실패를 모델의 감각에 맡기지 않고 코드로 정의된 상태 전이로 바꾸는 것입니다.
고객지원 봇이라면 더 안전한 흐름은 이렇습니다.
먼저 FAQ나 정책 문서를 검색하고,
근거가 충분할 때만 답하게 하고,
근거가 약하면 상담 연결로 넘기고,
환불 승인 같은 액션은 자동 실행하지 않습니다.
Anthropic의 가이드도 근거가 있으면 인용하고,
근거를 못 찾으면 주장을 철회하는 식으로 환각을 줄이라고 설명합니다.
[Anthropic: Reduce hallucinations]
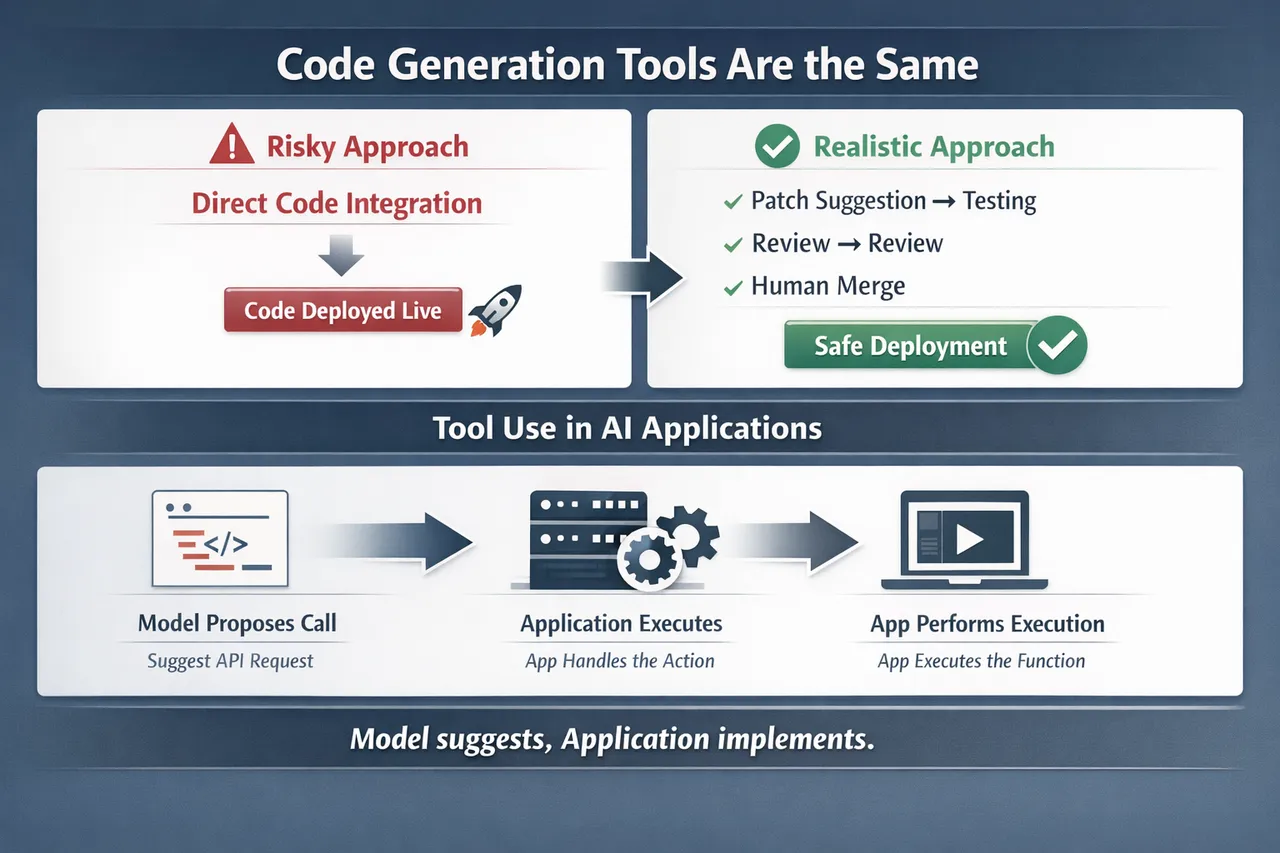
코드 생성 도구도 마찬가지입니다.
위험한 구조는 “코드 직접 반영”이고,
현실적인 구조는 “패치 제안 → 테스트 → 리뷰 → 사람이 머지”입니다.
Anthropic의 tool use 문서는 모델이 도구를 직접 실행하는 게 아니라,
애플리케이션이 정의한 계약에 따라 호출을 제안하고
실제 실행은 앱이 담당하는 구조를 설명합니다.
[Anthropic: Tool use overview]
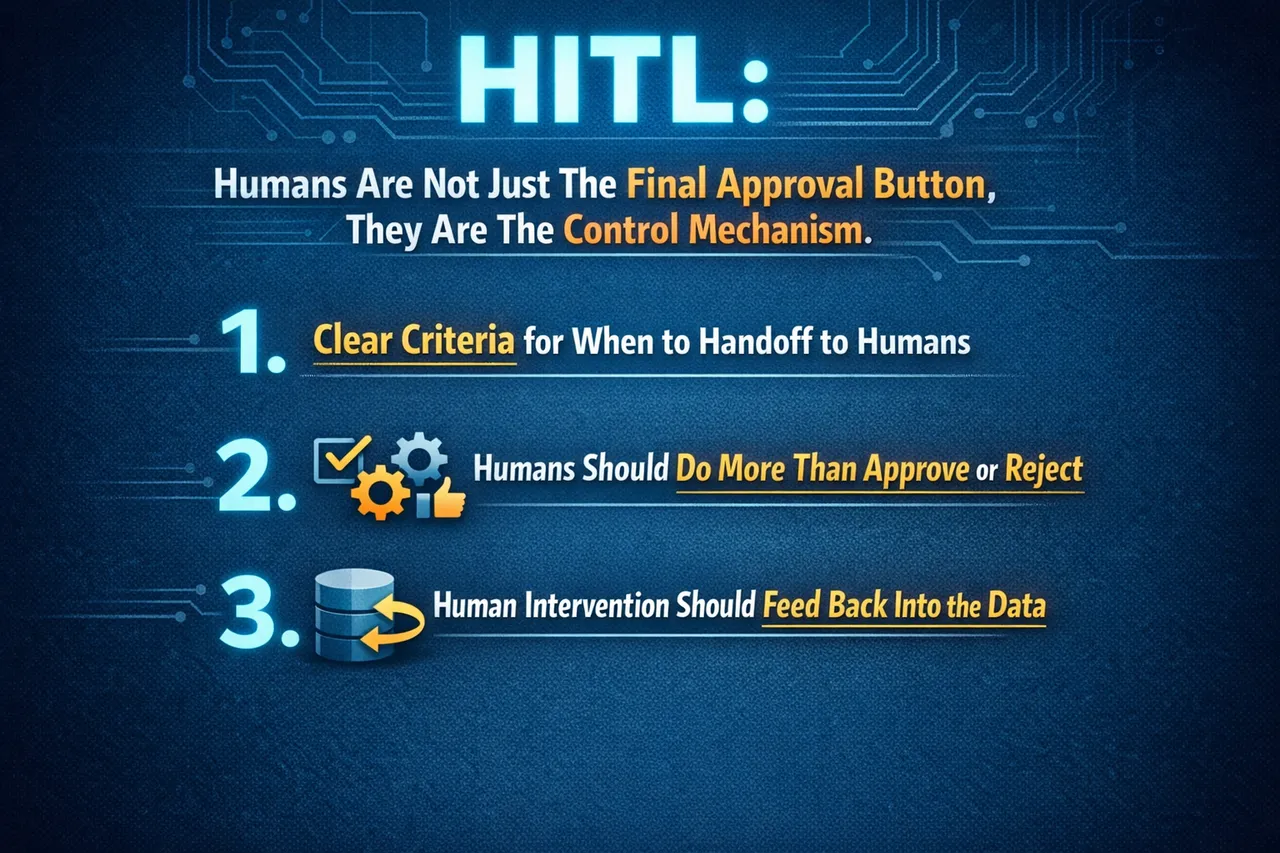
2. HITL: 사람은 마지막 승인 버튼이 아니라 제어 장치다
HITL이라고 하면 보통 “마지막에 사람 한 번 본다” 정도로 받아들여집니다.
그런데 실무에서 중요한 HITL은 그보다 훨씬 적극적입니다.
사람이 시스템 흐름을 멈추고, 수정하고, 다시 이어가게 하는 제어 지점에 가깝습니다.
Anthropic의 computer use 문서는
실제 환경 조작을 앱이 중간에서 통제하는 루프를 전제로 설명하고,
OpenAI도 고영향 작업에는 human oversight가 필요하다고 안내합니다.
[Anthropic: Computer use] [OpenAI: Computer use guide]
왜 중요할까요? LLM은 문장을 잘 만드는 엔진이지, 책임을 지는 주체가 아니기 때문입니다.
특히 아래 같은 액션은 사람 승인 없이 자동 실행하기 위험합니다.
SQL 실행
이메일 발송
파일 수정
권한 변경
외부 고객 커뮤니케이션
브라우저 기반 실제 조작
좋은 HITL은 세 가지를 갖습니다.
첫째, 언제 사람에게 넘길지 기준이 명확해야 합니다.
“좀 이상하면 넘기자”는 정책이 아니라 소원입니다.
대신 execute_sql이면 무조건 승인, confidence가 낮으면 승인,
PII가 감지되면 승인, 외부 발송이면 승인처럼 규칙이 있어야 합니다.
NIST도 인간-AI 구성과 운영 통제를 중요한 관리 항목으로 다룹니다.
둘째, 사람은 approve/reject만 하지 않아야 합니다.
수정, 보완, reroute, 근거 추가, 위험도 재분류, 에스컬레이션이 가능해야 합니다.
그래야 사람이 병목이 아니라 품질 안정화 장치가 됩니다.
셋째, 사람의 개입이 다시 데이터가 되어야 합니다.
누가 어떤 답을 reject했고, 무엇을 수정했고,
어떤 케이스가 오래 걸렸는지는 전부 다음 eval 세트의 씨앗입니다.
Anthropic도 성공 기준과 평가 루프를 먼저 설계하라고 권합니다.
이게 이론만은 아닙니다.
Atlassian의 HULA 연구는 사람 개입을 포함한 소프트웨어 개발 에이전트를
Jira 내부에 배치한 사례를 다룹니다.
논문은 HULA를 설계·구현·배포했다고 밝히고 있고,
Atlassian 엔지니어링 블로그도 개발자 효율을 높이되 인간이 통제권을 유지하는 구조라고 설명합니다. [HULA paper] [Atlassian engineering blog]
즉 메시지는 단순합니다.
에이전트가 개발자를 대체해서 배포된 게 아니라,
사람이 통제권을 유지했기 때문에 배포가 가능했다는 쪽에 가깝습니다.
3. Evaluation Stack: 평가는 리더보드가 아니라 회귀 방지 장치다
개발자들끼리 AI 얘기를 하다 보면 자꾸 “어느 모델이 더 좋다”로 흘러갑니다.
그런데 제품 개발에서 더 중요한 질문은 이겁니다.
이번 프롬프트 변경, 모델 교체, 검색 설정 수정이 서비스 품질을 망쳤는지 어떻게 확인할 건가?
이 질문에 답하는 게 Evaluation Stack입니다.
Anthropic은 task, trial, grader 같은 개념으로 평가를 구조화해야 한다고 설명하고,
OpenAI도 eval을 production 환경에서 모델 성능을 점검하는 핵심 수단으로 설명합니다.
[Anthropic: Demystifying evals for AI agents] [OpenAI: Evaluation best practices]
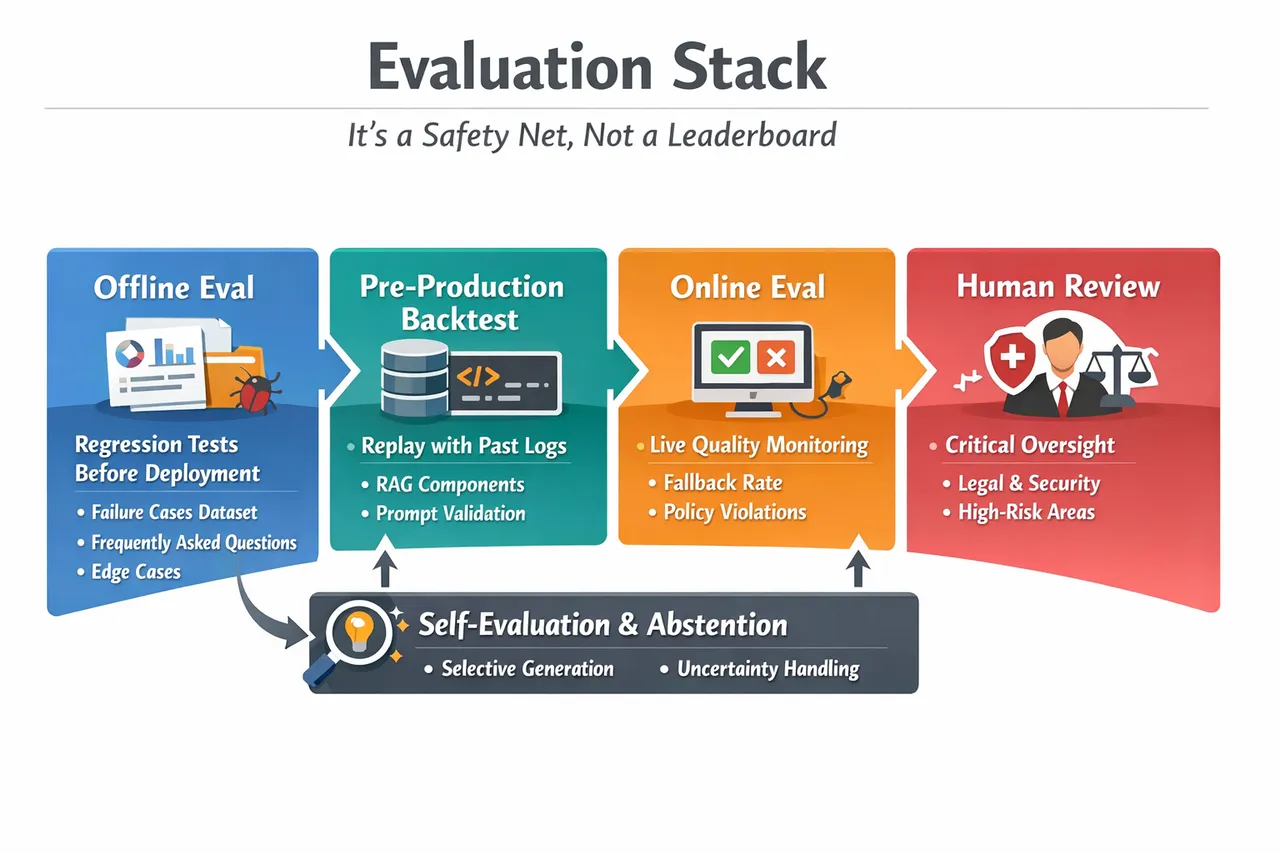
실무에서는 대체로 네 층으로 나눠 보면 이해가 쉽습니다.
Offline eval
배포 전에 돌리는 회귀 테스트입니다.
과거 실패 사례, 자주 들어오는 질문, edge case를 데이터셋으로 만들고 새 버전이 통과하는지 봅니다. Anthropic과 OpenAI 모두 “성공 기준을 먼저 정하고, 그것을 반복 평가하라”는
방향을 공통으로 제시합니다.
[Anthropic: Define success] [OpenAI: Evaluation best practices]
Pre-production backtest
새 모델이나 새 프롬프트, 새 retriever를 과거 실제 로그에 재생해 보는 단계입니다.
특히 RAG는 retriever, chunking, re-ranker, generation prompt가 서로 얽혀 있어서
한 부분만 바꿔도 전체 동작이 흔들립니다.
최근 연구도 RAG 평가에는 아직 일반적으로 합의된 방법론이 부족하고,
더 체계적인 평가 설계가 필요하다고 지적합니다.
[A Methodology for Evaluating RAG Systems]
Online eval
운영 중 품질 신호를 계속 보는 층입니다.
fallback 비율, 사람 승인 비율, override 비율, 정책 위반 탐지,
사용자 불만 신호, 비용 대비 성공률 같은 것들이 들어갑니다.
Anthropic의 2026년 eval 글도
task, trial, grader 관점에서 반복 측정이 필요하다고 설명합니다.
[Anthropic: Demystifying evals for AI agents]
Human review
가장 비싸지만 가장 중요한 층입니다.
법률, 재무, 보안처럼 실수가 비싼 영역에서는 자동 채점만으로 부족합니다.
NIST 역시 human oversight를 생성형 AI 위험 관리의 핵심 요소로 봅니다.
추가로, “모르면 말하지 않기”를 시스템 기능으로 보는 시각도 점점 중요해지고 있습니다.
Self-Evaluation Improves Selective Generation은
self-evaluation 기반 점수가 생성 품질과 더 잘 맞물린다고 보고했고,
Uncertainty-Based Abstention in LLMs는
불확실할 때 abstain 하는 전략이 정확도, 환각,
안전성 측면에서 개선을 줄 수 있다고 보고합니다.
즉, fallback과 eval은 따로 노는 게 아니라 이어져 있습니다.
[Selective Generation paper] [Uncertainty-Based Abstention paper]
4. 전체 구조를 한 장으로 보면
아래는 특정 벤더 기능명이 아니라, 대부분의 LLM 앱에 적용할 수 있는 범용 설계 패턴입니다.
이 구조에서 핵심은 한 줄로 요약됩니다.
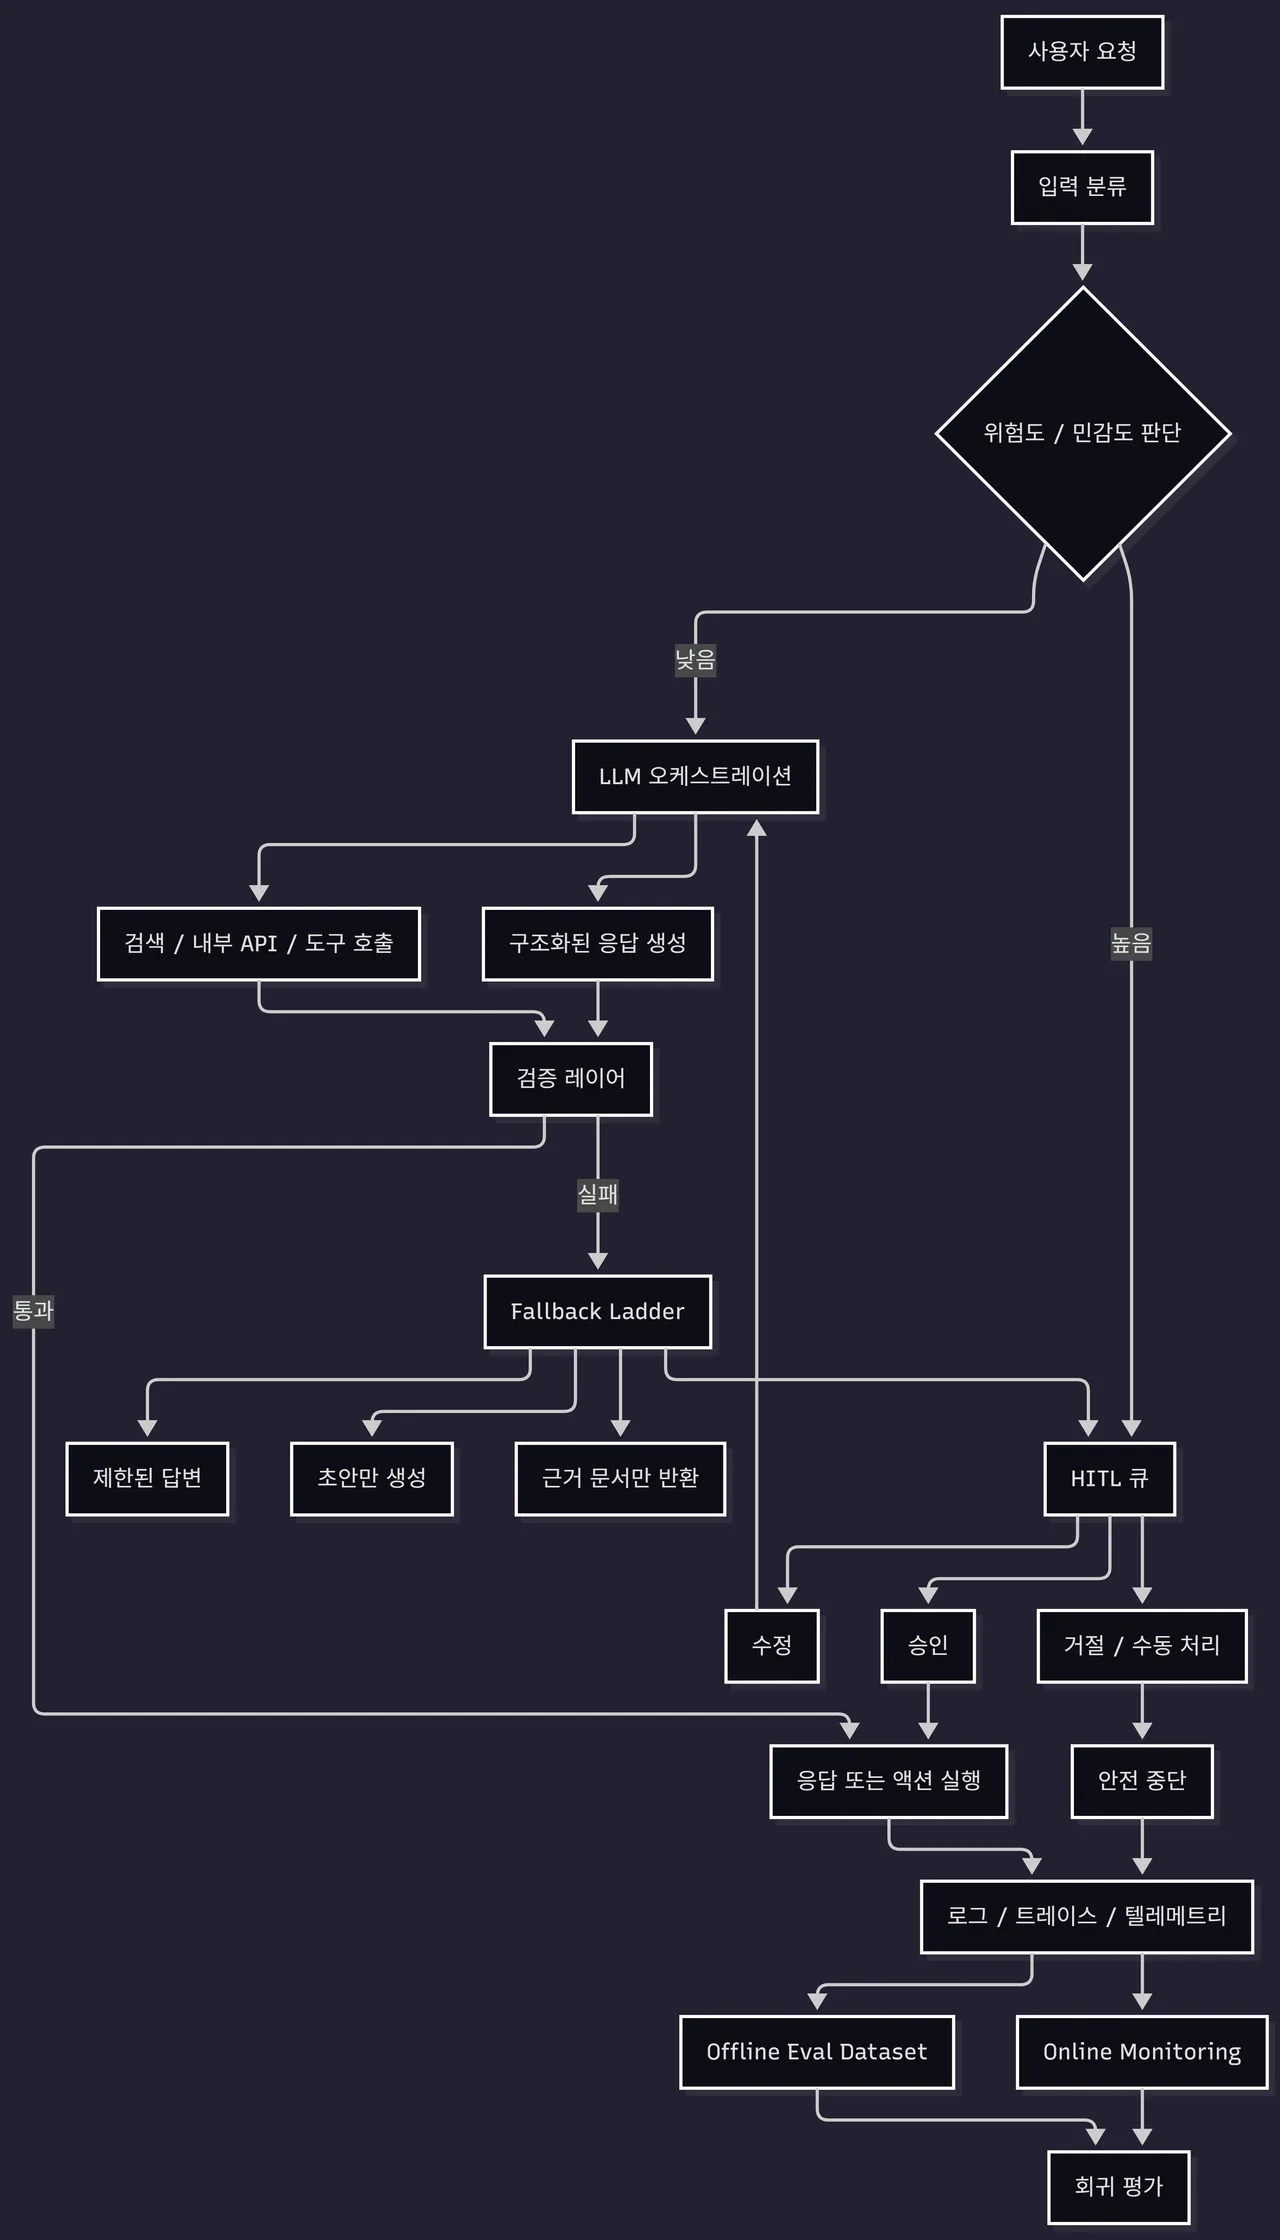
모델은 제안하고, 검증기는 걸러내고, 시스템이 실행권을 부여하고, 사람은 필요한 순간 흐름을 멈춘다.
구조화된 출력, 명시적 도구 계약, 문서 인용, human oversight, 평가 루프,
격리된 실행 환경이 여러 문서에서 반복해서 등장하는 이유도 여기에 있습니다.
[OpenAI: Structured outputs] [Anthropic: Citations]
5. 일반 개발자가 오늘 바로 적용할 수 있는 순서
거대한 AI 플랫폼부터 만들 필요는 없습니다. 보통은 아래 순서가 가장 현실적입니다.
1) 출력부터 구조화하기
자유 텍스트를 그대로 후속 로직에 연결하지 말고,
적어도 answer, confidence, citations, needs_human_review, action_type 같은 필드는
구조화해서 받는 편이 낫습니다.
OpenAI의 structured outputs와 Anthropic의 citations/tool use는 이름은 달라도,
결국 자유 문장을 검증 가능한 객체로 바꾸는 방향이라는 점에서 같습니다.
[OpenAI: Structured outputs] [Anthropic: Citations]
2) 위험한 액션은 한 단계 낮추기
처음부터 자동 실행하지 마세요.
이메일 발송은 초안으로, SQL 실행은 미리보기로,
코드 변경은 patch preview로 낮추는 편이 안전합니다.
이건 모델 성능과 별개로 사고 반경을 줄여줍니다.
3) fallback 조건을 코드로 적기
citation이 없으면 fallback, confidence가 낮으면 fallback,
schema validation 실패면 fallback,
정책 분류 실패면 HITL 같은 조건은 문서가 아니라 코드와 테스트에 있어야 합니다.
eval도 결국 이런 규칙을 검증 가능한 형태로 만드는 작업입니다.
4) 실패 사례를 모아 작은 eval 세트 만들기
운영 중 틀린 답 20개,
위험했던 케이스 20개,
애매했던 사례 20개만 모아도 시작점으로 충분합니다.
Anthropic과 OpenAI 모두 작은 평가 세트에서 시작해 반복적으로 개선하는 방향을 권장합니다. [Anthropic: Define success] [OpenAI: Evaluation best practices]
5) 사람 검토 로그를 버리지 않기
사람이 “이건 안 됨”, “이건 이렇게 고쳐야 함”이라고 남긴 흔적은
아주 비싼 데이터입니다.
그걸 다음 eval에 넣어야 시스템이 나아집니다.
6. 흔한 실수
첫째, 모델만 바꾸면 해결될 거라고 믿는 것입니다.
모델 업그레이드는 도움이 되지만, fallback과 validation이 없으면 더 그럴듯하게 틀릴 뿐입니다.
둘째, HITL을 너무 늦게 붙이는 것입니다.
“일단 자동화부터 하고 승인 흐름은 나중에 넣자”는 생각이 흔한데,
실제로는 반대입니다.
승인 경계 없이 자동화를 먼저 열면 나중에 브레이크를 끼우기가 더 어렵습니다.
셋째, 평가를 데모 점수로 끝내는 것입니다.
내가 고른 예시 10개에서 잘 되는 건 큰 의미가 없습니다.
운영 로그에서 실패 사례를 계속 끌어와야 합니다.
평가가 장식장이 되면 배포는 결국 운 시험이 됩니다.
[Anthropic: Demystifying evals for AI agents]
결론
AI 앱에서 중요한 건 “얼마나 똑똑하게 말하느냐”보다 얼마나 안전하게 틀리느냐입니다.
Deterministic Fallback은 모델이 애매할 때 안전한 길로 내려가게 합니다.
HITL은 위험한 액션 앞에서 사람에게 제어권을 돌려줍니다.
Evaluation Stack은 변경이 들어와도 품질이 무너지지 않게 붙잡아 줍니다.
벤더마다 기능 이름과 API는 달라도 방향은 꽤 비슷합니다.
구조화된 출력, 명시적 도구 계약, 문서 인용, 인간 개입, 평가 루프, 격리된 실행 환경이
반복해서 등장하는 이유가 여기에 있습니다.
NIST의 프레임워크, Anthropic과 OpenAI의 최신 문서,
그리고 HULA나 selective generation 계열 연구가 공통으로 가리키는 방향도 같습니다.
좋은 AI 제품은 마법 같은 제품이 아니라, 실패했을 때도 예측 가능한 제품입니다.
마치며
AI 앱을 실무에 넣을 때 왜 Deterministic Fallback, HITL, Evaluation Stack이 중요한지 정리했습니다.
특정 벤더에 묶이지 않는 범용 설계 패턴, 실제 실패 시나리오, 아키텍처 다이어그램,
공식 문서와 논문 출처를 함께 담았습니다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.