


안녕하세요! 오늘은 AI 업계를 뒤흔들고 있는 구글의 최신 모델, Gemini 3.1 Flash-Lite 소식을 들고 왔습니다.
그동안 AI 서비스를 운영하면서 가장 큰 고민은 역시 '비용'과 '속도'였죠? 이번 모델은 그 고민을 정면으로 해결해 줍니다.
무엇이 달라졌나(공식 포인트)
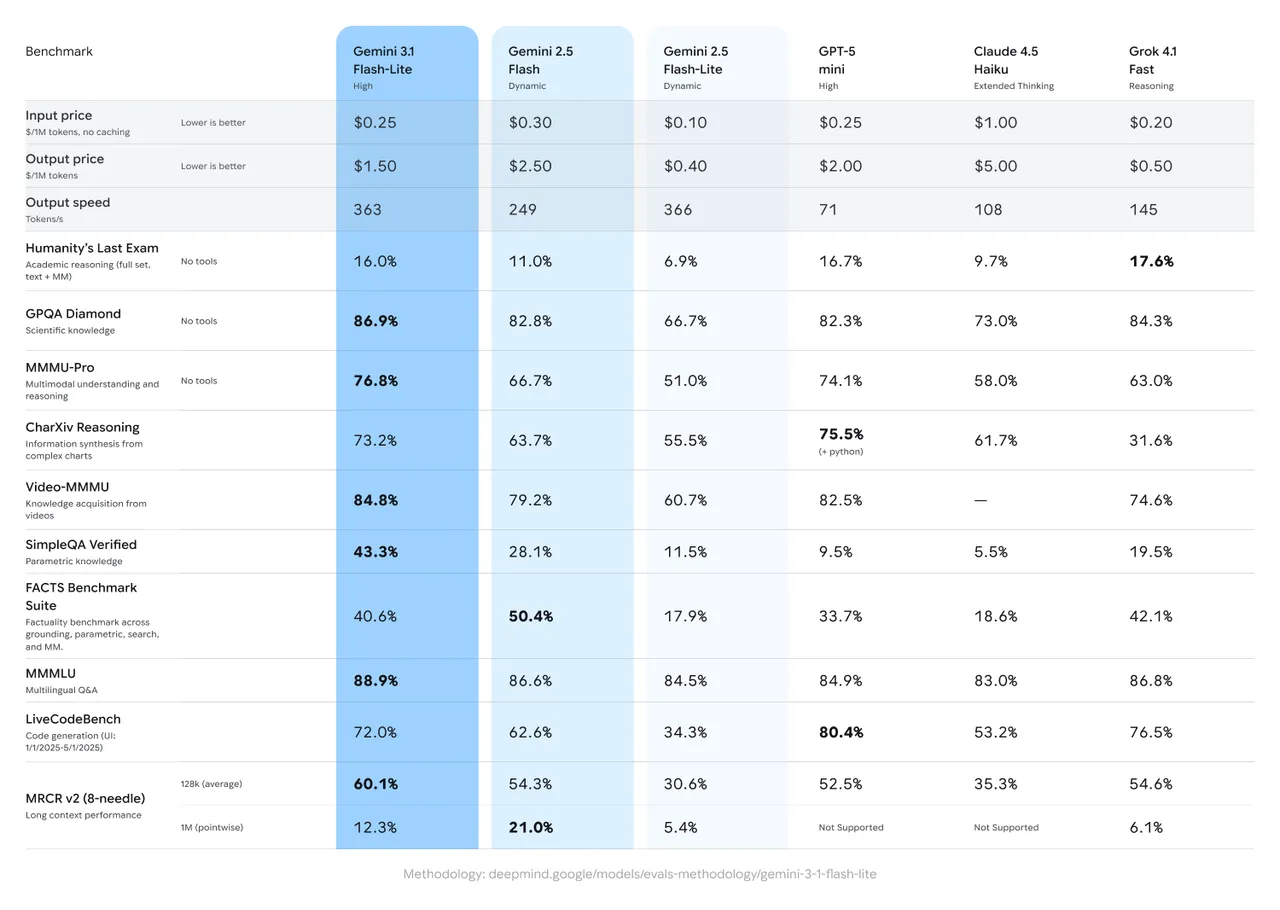
Gemini 3.1 Flash-Lite는 Gemini 3 시리즈 중 ‘가장 빠르고 비용 효율적인’ 모델로, 대량 트래픽(high-volume workloads)을 전제로 설계된 개발자용 프리뷰입니다.1
현재는 Gemini API(Google AI Studio)에서 프리뷰로 제공되며, 기업 환경에서는 Vertex AI를 통해 프리뷰로 사용할 수 있습니다.1
왜 Gemini 3.1 Flash-Lite인가?
미친 가성비: 입력 $0.25 / 1M 토큰, 출력 $1.50 / 1M 토큰(공식 가격 기준)입니다.1 번역/분류/모더레이션처럼 대량 처리에서는 토큰 단가가 곧 운영비로 직결됩니다.
압도적인 속도: 초당 363개 토큰 수준의 출력 속도가 언급됩니다.2 또 공식 발표 기준으로는 Gemini 2.5 Flash 대비 첫 토큰 응답(Time to First Answer Token)이 2.5배 빨라졌고, 출력 속도도 45% 증가했습니다.1
지능의 완급 조절: AI Studio/Vertex AI에서 thinking levels를 기본 제공해, 작업별로 ‘얼마나 생각할지’를 직접 고를 수 있습니다.1 번역/모더레이션처럼 단순·반복 작업은 낮게 두고 비용과 지연을 줄이며, UI 생성/시뮬레이션/복잡한 지시 이행처럼 정확도가 중요한 작업은 높여 품질을 끌어올리는 식으로 트레이드오프를 제어합니다.
추천 사용처
대량 번역
콘텐츠 모더레이션/분류
UI/대시보드 생성
시뮬레이션/복잡한 지시 이행
성능/벤치마크
Arena.ai 기준 Elo 1432, GPQA Diamond 86.9%, MMMU Pro 76.8%가 공개되었습니다.1 요약하면 동급 티어 대비 추론과 멀티모달 이해에서 강점을 보이는 편입니다.
참고로 GPT 5.2 는 GPQA Diamond 가 92.4% 입니다.
아래는 위에서 언급한 성능 지표를 GPT-5.2와 동일한 형태로 맞춰 비교한 표입니다.
정리하면 GPQA Diamond 기준으로는 GPT-5.2가 더 높고(92.4% vs 86.9%), Flash-Lite는 '대량 처리/가성비' 포지션에서 경쟁하는 모델이라 성능만으로 1:1 우열을 말하기보다 비용·지연까지 함께 비교하는 게 맞습니다.
이제 성능 때문에 비싼 모델을 고집하거나, 속도 때문에 사용자 경험을 포기할 필요가 없습니다. Flash-Lite는 ‘대량 처리’에서 비용·지연을 동시에 낮추는 실전형 선택지입니다.
참고
1Gemini 3.1 Flash-Lite: Built for intelligence at scale
2Google's fastest and cheapest model Gemini 3.1 Flash-Lite got smarter but also tripled the price
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.