

한 줄 요약
Mercury 2는 "토큰을 한 글자씩 찍는" 방식이 아니라, 초안을 병렬로 다듬어 수렴시키는 확산(diffusion) 생성으로 실시간에 가까운 추론 속도를 노리는 생산(Production) 지향 LLM이다.1
Mercury 2는 무엇인가
Mercury 2(머큐리 2)는 Inception Labs가 공개한 확산 기반(dLLM) "추론(reasoning)" 언어모델로, 목표가 명확하다. 대화형 데모에서 똑똑해 보이는 모델이 아니라, 에이전트 루프·검색 파이프라인·추출 작업처럼 호출이 반복되는 환경에서 체감 지연을 줄여 "즉각 반응하는 제품"을 만드는 쪽에 초점을 둔다.1
여기서 흔히 오해하는 지점이 하나 있다. 과거에 "Stable 기반" 같은 표현이 섞여 돌기도 하는데, Mercury 2의 'stable'은 Stable AI 같은 특정 회사가 아니라 Stable Diffusion으로 대표되는 '확산' 계열 생성 방식과의 유사성을 말하는 맥락에 가깝다. Mercury 2의 정체성은 회사가 직접 밝히듯 "diffusion for language"다.12
Mercury 2는 OpenAI API 호환을 내세워 기존 스택에 "드롭인"으로 넣는 접근도 강조한다.1
왜 '확산 기반'이 중요한가(자기회귀 AR과 비교)
자기회귀(AR) LLM은 왼쪽에서 오른쪽으로 한 토큰씩 순차 디코딩한다. 그래서 추론을 더 하게 만들수록(더 긴 체인, 더 많은 샘플링/재시도) 속도·비용이 정직하게 늘어난다. "똑똑함을 사면, 지연과 비용을 같이 산다"는 구조적 트레이드오프가 생긴다.12
Mercury 2가 내세우는 확산 방식은 비유하자면 타자기보다 편집기에 가깝다. 처음부터 답의 형태를 대략 잡고, 여러 토큰을 동시에 고치며 몇 번의 스텝으로 수렴한다. Inception은 이 병렬 정제가 속도 곡선을 바꾼다고 말한다(">5x faster generation").1
이 차이는 "한 번의 응답"보다 "반복 호출"에서 의미가 커진다. 에이전트가 계획-도구호출-검증-재시도 같은 단계를 여러 번 돌릴 때, 지연은 한 번이 아니라 누적되기 때문이다.1
공개된 스펙/특징(속도, 컨텍스트, 툴 사용, JSON 등)
Inception Labs가 공개한 발표 기준 스펙은 다음 메시지로 정리된다. 속도는 NVIDIA Blackwell GPU에서 1,009 tokens/sec, 컨텍스트는 128K, 기능으로 native tool use와 schema-aligned JSON output, 그리고 tunable reasoning을 언급한다.1
가격 또한 발표 기준으로 입력 $0.25/1M tokens, 출력 $0.75/1M tokens로 제시됐다.1
아래 이미지는 보도자료 유통본에 포함된 "Mercury 2 Speed Benchmarks"로, 회사가 주장하는 속도 포지셔닝('1,000 tps' 급)을 한 장으로 보여준다.

이미지 출처: Inception Launches Mercury 2, the Fastest Reasoning LLM -- 5x Faster ...
그리고 Mercury "패밀리" 관점에서 보면, Inception은 이미 1세대 발표에서 "H100에서 1000+ tokens/sec" 같은 수치를 전면에 놓고, dLLM을 RAG·툴 사용·에이전트 워크플로에 그대로 적용 가능한 대체재로 설명해 왔다. Mercury 2는 그 연장선에서 "추론까지 실시간으로"를 더 강하게 밀어붙인 버전으로 읽힌다.2
활용 시나리오(코딩/에이전트 루프/실시간 음성/검색·RAG)
Mercury 2가 가장 설득력 있어지는 지점은 "똑같은 일을 더 빨리"가 아니라, 속도 때문에 가능해지는 제품 경험이다.
코딩과 편집에서는 자동완성·리팩터링·다음 수정 제안처럼 사람이 화면을 보며 고치는 흐름에서 멈칫거림이 사라지는 게 핵심이다. Inception은 "생각의 일부처럼 도착한다"는 식으로, 지연이 UX를 끊는 문제를 정면으로 다룬다.1
에이전트 루프에서는 호출이 수십 번 이어지므로, 호출당 수백 ms만 줄여도 전체 태스크 시간이 크게 줄고 "더 많은 단계"를 돌릴 여유가 생긴다. 즉 품질(검증/재시도/도구 사용)을 속도로 구매하는 구조가 된다.1
실시간 음성은 지연 예산이 가장 빡빡한 영역이다. 자연스러운 대화 리듬을 깨지 않으려면 텍스트 생성이 빨라야 하고, 여기서 확산 기반의 고속 생성이 "추론급 품질을 실시간에 넣는다"는 논리로 연결된다.1
검색·RAG는 멀티홉 검색, 재랭킹, 요약 등 파이프라인 지연이 층층이 쌓인다. Mercury 2는 "추론을 루프 안에 넣어도 SLA를 망치지 않게" 하는 방향으로 포지셔닝한다.1
강점과 한계(검증 관점 포함)
Mercury 2의 강점은 속도를 "서빙 최적화의 결과"가 아니라 "생성 방식 자체의 변화"로 제시한다는 점이다. Inception은 순차 디코딩의 سق(천장)을 우회해, 추론을 더 돌리면서도 실시간 예산을 맞출 수 있다고 주장한다.1
또 하나의 강점은 제품 개발 관점이다. OpenAI API 호환, 툴 사용, 스키마 기반 JSON 같은 기능을 앞에 둔 것은 "멋진 연구"보다 "운영 가능한 시스템"을 우선순위로 둔 선택처럼 보인다.1
하지만 한계도 명확하다. 첫째, 핵심 수치(1,009 tokens/sec, >5x 등)는 회사 발표 기준이며, 워크로드·동시성·스트리밍 형태·GPU/서빙 스택에 따라 체감은 달라질 수 있다. Inception 스스로도 p95 지연, 높은 동시성에서의 일관된 처리량 같은 "사용자가 느끼는 속도"를 강조하는데, 이는 곧 외부 환경에 따라 결과가 흔들릴 수 있음을 반대로 말해준다.1
둘째, 확산의 "반복 정제"가 항상 정답을 보장하진 않는다. Mercury(1세대) 글에서도 "수정 가능/오류 교정 가능"을 장점으로 말하지만, 실제로는 정렬·도구 호출 신뢰성·환각 억제 같은 문제를 얼마나 덜 틀리게 만들었는지 별도의 평가 설계가 필요하다.2 특히 에이전트나 RAG는 단일 정답률보다 "실패했을 때의 안전한 실패, 재시도 비용, 로그 기반 디버깅 가능성"이 더 중요해져서, 벤치마크 점수만으로는 부족하다.
셋째, "속도 최적화 모델들과 경쟁적 품질"이라는 표현 역시 포괄적이라, 내가 쓰려는 도메인(예: 수학 추론, 코드 수정, 장문 요약, 구조화 추출)에서의 품질-지연 곡선을 직접 확인해야 한다.1
추후 전망(아키텍처 트렌드·제품화 관점)
아키텍처 트렌드로 보면, Mercury 2는 "더 큰 모델" 경쟁과는 다른 축--지연을 줄여 루프 자체를 바꾸는 모델--을 전면에 놓는다. 앞으로는 '지능'이 아니라 '지능/초(초당 유용한 작업량)'이 제품 경쟁력으로 더 자주 측정될 가능성이 크다. 특히 에이전트가 표준 UX가 될수록, 호출당 몇 초가 아니라 호출당 몇 백 ms가 전체 비용과 만족도를 가른다.1
제품화 관점에서는, 확산 기반이 "빠른 생성"을 넘어 "구조화 출력의 안정성"과 결합될 때 파급이 커진다고 본다. 스키마에 맞춘 JSON과 툴 사용은 단지 편의 기능이 아니라, 에이전트 운영에서 실패율을 줄이는 장치다. 다만 이 지점은 발표 스펙을 넘어, 실제 현업 트래픽에서의 실패 패턴(예: 잘못된 함수 호출, 필드 누락, 근거 없는 확신)을 얼마나 줄이느냐로 판가름 날 것이다.1
마지막으로, Mercury(1세대)에서 Mercury 2로의 흐름은 "확산 기반 LLM이 가능하다"에서 "확산 기반 추론이 운영에 들어갈 수 있다"로 무게중심이 이동한 것으로 읽힌다.21 만약 외부 검증에서 속도 이점이 재현되고, 품질이 '중간급'에서 '대부분의 실무에 충분' 수준으로 올라오면, 확산은 텍스트 영역에서도 이미지/비디오처럼 하나의 주류 생성 패러다임으로 자리 잡을 여지가 있다.
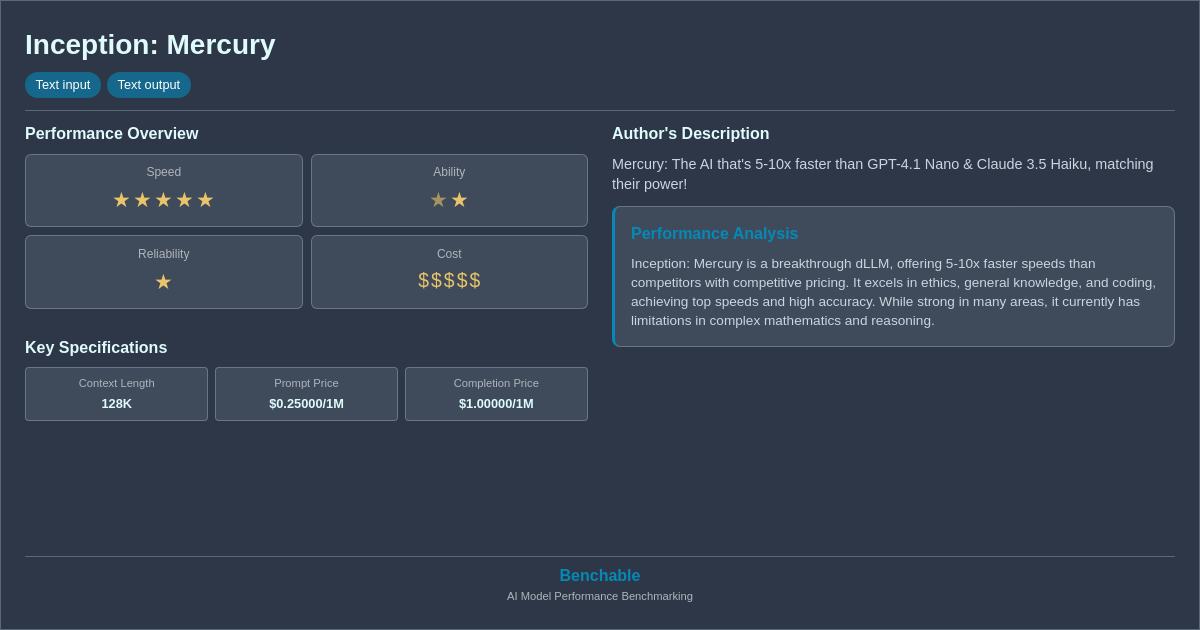
이미지 출처: Inception: Mercury - AI Model Details & Benchmarks
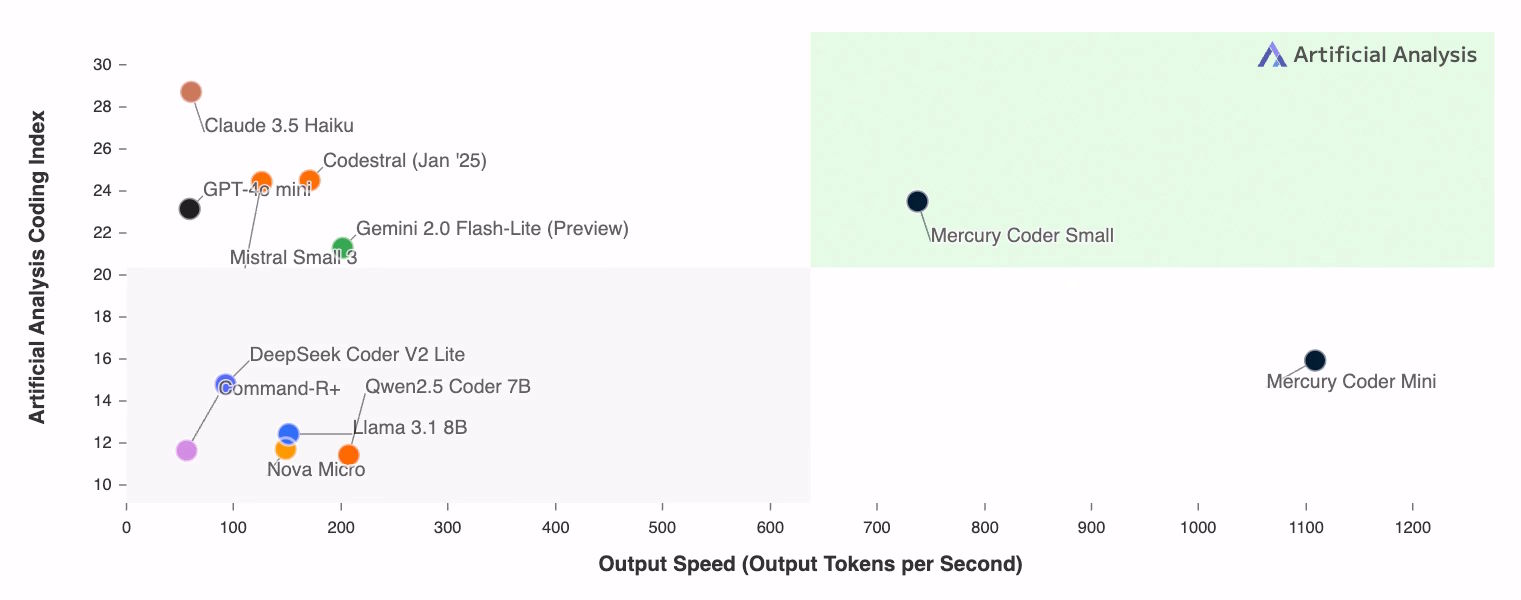
이미지 출처: Inception Labs introduces its Mercury Series of diffusion-based LLMs
참고
1Introducing Mercury 2 - Inception
2Introducing Mercury, the World's First Commercial-Scale Diffusion Large Language Model - Inception
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.