


1. 서론: 대규모 언어 모델의 성능 변동성과 비용 최적화 패러다임
최근 소프트웨어 공학 및 데이터 과학 분야에서 대규모 언어 모델(Large Language Models, LLMs)은 단순한 보조 도구를 넘어 핵심적인 개발 파트너로 자리 잡았다. 서비스 초기, 제공자(Anthropic, OpenAI 등)들은 시장의 지배력을 확보하고 압도적인 지능적 우위를 증명하기 위해 무거운 가중치와 최대 연산량을 허용하며 사용자들에게 최고 수준의 퍼포먼스를 제공했다. 이러한 전략은 사용자들에게 AI의 잠재력에 대한 확신을 심어주었으나, 1억 명 이상의 활성 사용자가 매일 수십억 개의 토큰을 생성하는 현재의 트래픽 환경에서는 인프라의 물리적 한계와 막대한 API 호출 비용이라는 현실적인 벽에 부딪히게 되었다.
인공지능 모델의 추론(Inference) 과정은 GPU 메모리 대역폭과 컴퓨팅 사이클을 기하급수적으로 소비한다. 칩셋 확보 비용과 막대한 전력 소모를 감당하기 위해, 서비스 제공자들은 수익성을 유지하고 서버 다운타임을 방지하는 차원에서 백그라운드 튜닝(Background tuning)을 지속적으로 단행하고 있다. 이러한 비용 절감 프로세스는 모델의 표면적인 버전 명칭(예: GPT-4o, Claude 3.5 Sonnet)을 유지한 채 은밀하게 진행되며, 컴퓨팅 리소스의 '슈링크플레이션(Shrinkflation)' 현상을 야기한다.
경험이 풍부한 소프트웨어 엔지니어와 심층 사용자(Power User)들은 특정 시점을 기점으로 모델이 명백히 '게을러졌다(Lazy)'거나, 복잡한 문제 해결 능력이 급감하는 지수적 퍼포먼스 하락을 일관되게 체감하고 있다. 본 리포트는 단톡방 및 글로벌 개발자 커뮤니티에서 통찰력 있게 제기된 "비용 절감 차원의 라우팅 및 양자화 조정"이라는 가설을 기술적 메커니즘 차원에서 철저히 규명한다. 나아가, 자연어 기반의 '바이브 코딩(Vibe Coding)'을 적극적으로 수용하는 현대의 엔지니어들이 이러한 제약 환경 속에서 어떻게 인프라의 한계를 우회하고 생산성을 극대화할 수 있는지에 대한 시스템적, 아키텍처적 대응 전략을 심층적으로 제안한다.
2. 현상 파악: 서비스 제공자의 백그라운드 인퍼런스 최적화 기술 심층 분석
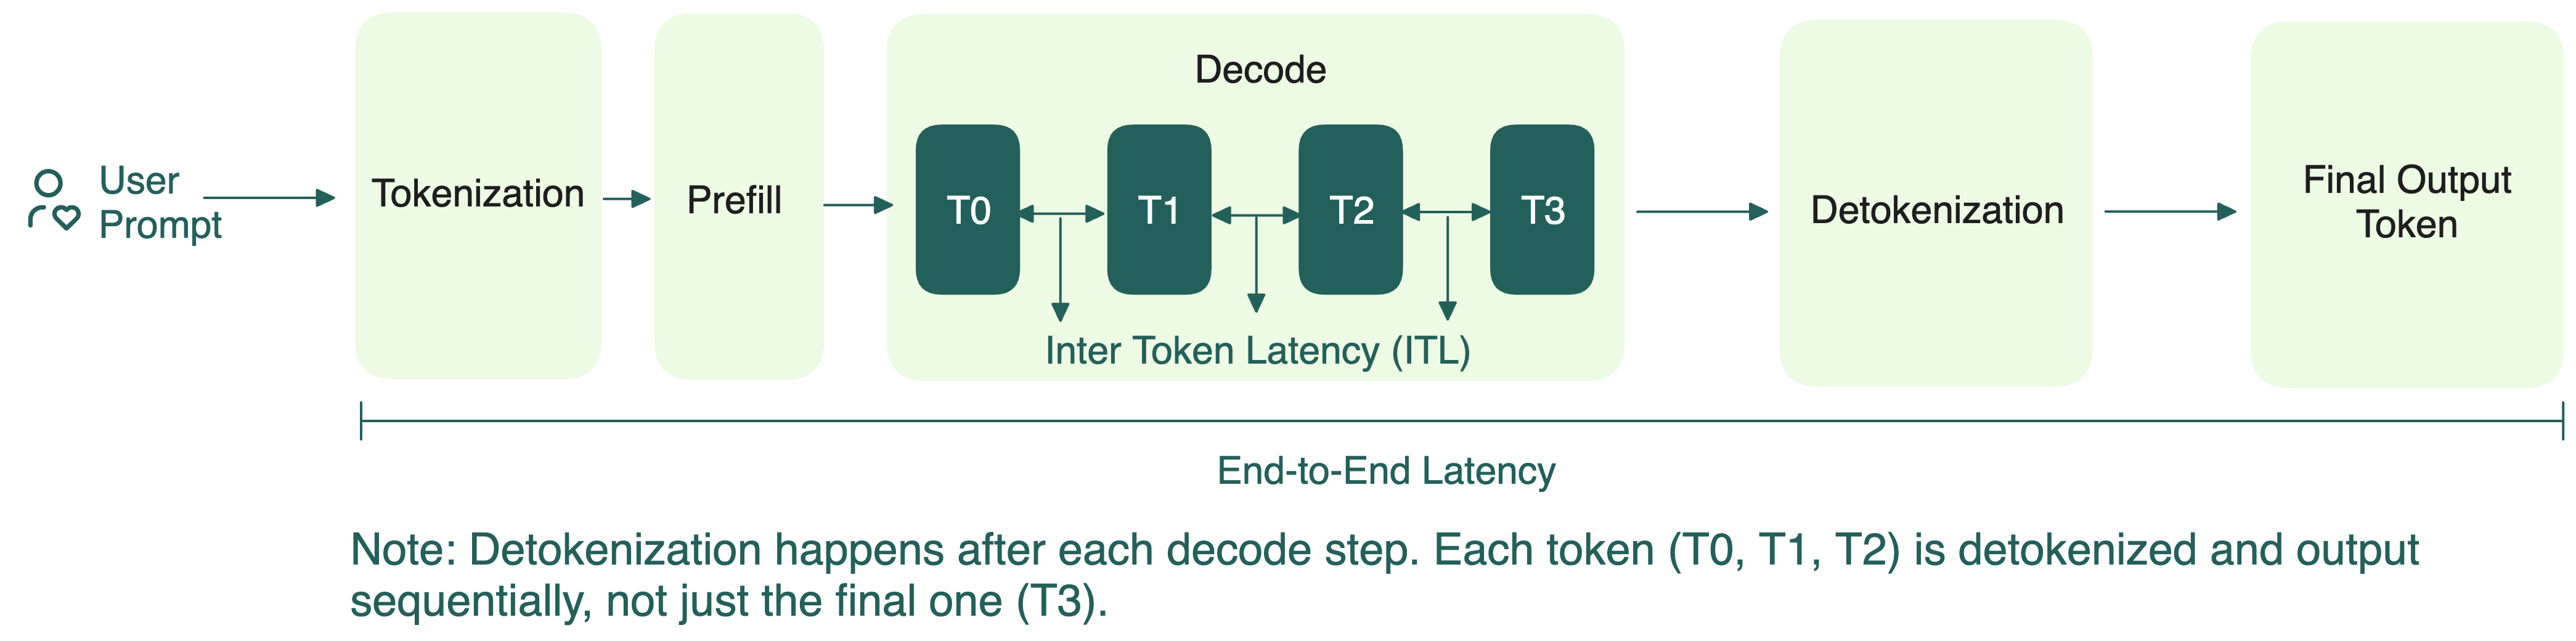
대규모 언어 모델의 추론 지연 시간과 비용은 토큰을 처리하는 프리필(Prefill) 단계와 토큰을 생성하는 디코딩(Decoding) 단계로 나뉜다. 프리필 단계는 입력 프롬프트의 모든 토큰을 병렬로 처리하므로 컴퓨팅 집약도가 높지만, 디코딩 단계는 다음 토큰을 생성하기 위해 수십억 개의 활성 파라미터를 메모리에서 반복적으로 불러와야 하므로 데이터 이동(Data movement)에 의한 병목 현상이 극심하게 발생한다. 디코딩 시간이 전체 추론(End-to-end latency)의 대부분을 차지하는 단일 배치(Single-batch) 서빙 환경에서, 제공자들은 메모리 대역폭의 한계를 극복하고자 고도의 구조적 경량화 경로를 도입하고 있다.
프리필-디코드 분리(Disaggregation) 개념도
이미지 출처: Prefill-decode disaggregation | LLM Inference Handbook
2.1 혼합 전문가(MoE) 아키텍처와 동적 라우팅(Dynamic Routing) 메커니즘
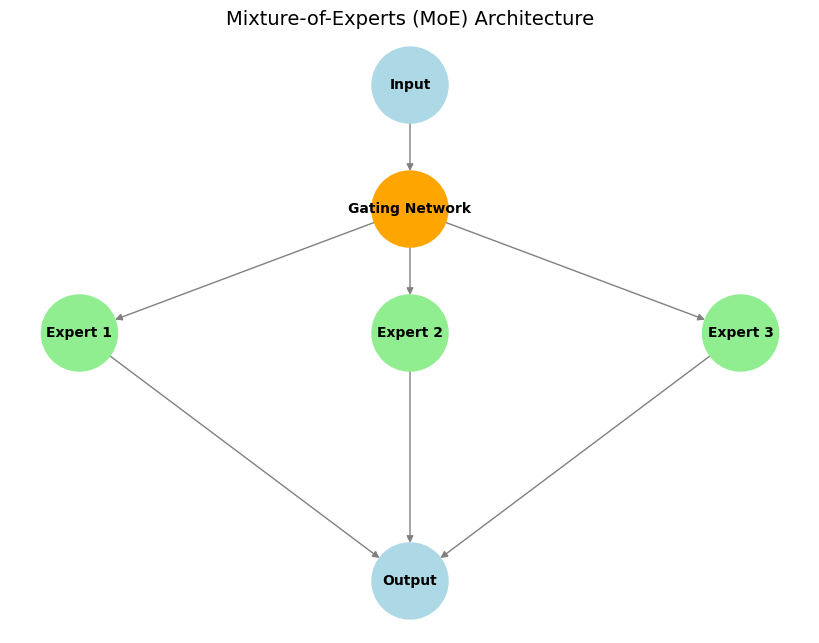
현존하는 최고 성능의 프론티어 모델(Llama 4, GPT-5 시리즈, Claude 4 시리즈, DeepSeek R1 등)은 예외 없이 혼합 전문가(Mixture-of-Experts, MoE) 아키텍처를 채택하고 있다. MoE 아키텍처는 모델의 밀집 MLP(Dense MLP) 블록을 여러 개의 전문화된 하위 네트워크(전문가)로 대체하고, 라우팅 메커니즘을 통해 각 토큰마다 전체 파라미터가 아닌 일부 전문가 파라미터만 희소하게 활성화(Sparsely activated)하는 방식이다. 이는 밀집 모델과 동등한 연산 효율성을 유지하면서도 모델의 지능적 용량을 기하급수적으로 확장할 수 있는 장점을 지닌다.
그러나 MoE 시스템은 전문가 파라미터가 메모리를 과도하게 점유하고 로딩 지연을 유발하며, 다수의 토큰이 단일 전문가만을 필요로 하는 등 활성화된 전문가들의 중복(Redundancy)이 발생한다는 치명적인 단점을 내포하고 있다. 이를 해결하고 연산 비용을 통제하기 위해 제공자들은 동적 라우팅 알고리즘에 엄격한 자원 제한을 가한다.
라우팅 계층은 특정 토큰이 주어졌을 때 각 전문가 모델의 적합성을 평가하여 확률 분포를 계산하며, 이 확률이 사전 정의된 임계값(Threshold) $p$를 초과할 경우에만 해당 전문가를 추가로 활성화한다. 서비스 초기에는 이 임계값을 낮추어 가장 똑똑하고 무거운 전문가가 복잡한 논리를 처리하도록 허용했다. 하지만 트래픽이 폭증하고 서버가 한계 부하에 도달하면, 제공자 측 라우터는 동적으로 가중치를 조정하여 이전에는 100의 난이도로 처리되던 고도화된 프롬프트를 80 정도의 하위 전문가 모델로 라우팅해버린다. 결과적으로 사용자는 논리적 결함이 있거나 문맥을 깊이 이해하지 못한 '대충 마무리된' 형태의 결과물을 받게 된다.
라우팅 알고리즘 자체의 결함도 퍼포먼스 하락에 기여한다. 전통적인 해시 라우팅(Hash routing)은 완벽한 부하 분산을 이루지만 문맥을 무시하여 성능을 저하시키는 반면, 업계 표준으로 자리 잡은 학습된 라우팅(Learned routing) 알고리즘은 성능을 약 4% 개선하지만, 초기 및 후기 레이어에서 대부분의 토큰이 1~2개의 특정 전문가에게만 몰리는 '라우터 붕괴(Router Collapse)' 현상을 유발한다. 이를 방지하기 위해 DeepSeek-V3나 Qwen2와 같은 모델들은 항상 활성화되는 공유 전문가(Shared experts)를 도입하거나 , Google의 Expert Choice (EC) 라우팅처럼 이질적인 토큰-전문가 매핑을 허용하여 로드 밸런싱을 강제하고 있다. 이러한 서버 측의 부하 분산 로직 개입은 개별 사용자의 프롬프트가 최적의 전문가를 할당받을 확률을 구조적으로 제한한다.
MoE 아키텍처 개요
 이미지 출처: Understanding the Mixture of Experts (MoE) Architecture | Birow
게이팅 네트워크(라우터)와 전문가 선택 예시
 이미지 출처: A Gentle Introduction to Mixture of Experts Ensembles ...
MoE 동작을 설명하는 시각 자료(토큰→전문가 라우팅 개념)
 이미지 출처: A Visual Guide to Mixture of Experts (MoE)
정해진 규칙에 따라 토큰을 분배하여 완벽한 부하 분산 유지
토큰의 의미론적 문맥을 완전히 무시하므로 모델의 전반적인 추론 성능이 극심하게 저하됨.
학습된 라우팅 (Learned Routing)
선형 계층이 토큰별 전문가 로그 확률(Logits)을 출력하여 적합한 전문가 선택
성능은 우수하나 트래픽 집중 시 일부 전문가에 과부하가 걸리는 라우터 붕괴(Router collapse) 발생. 분산 학습 병목의 원인.
임계값 기반 동적 할당
확률 분포 계산 후, 최고 확률이 임계값 $p$를 넘을 때만 다중 전문가 활성화
비용 절감의 핵심 통제 수단. 서버 부하 시 임계값을 높여 하위 전문가에게 강제 할당함으로써 품질의 지수적 하락 유발.
전문가 선택 라우팅 (EC)
네트워크 부분 활성화를 토큰 단위가 아닌 예제(Example) 단위로 이질적 매핑
최적의 부하 분산을 강제하지만, 특정 전문가의 과대/과소 훈련 방지를 명분으로 사용자 쿼리의 최상위 처리를 제한할 수 있음.
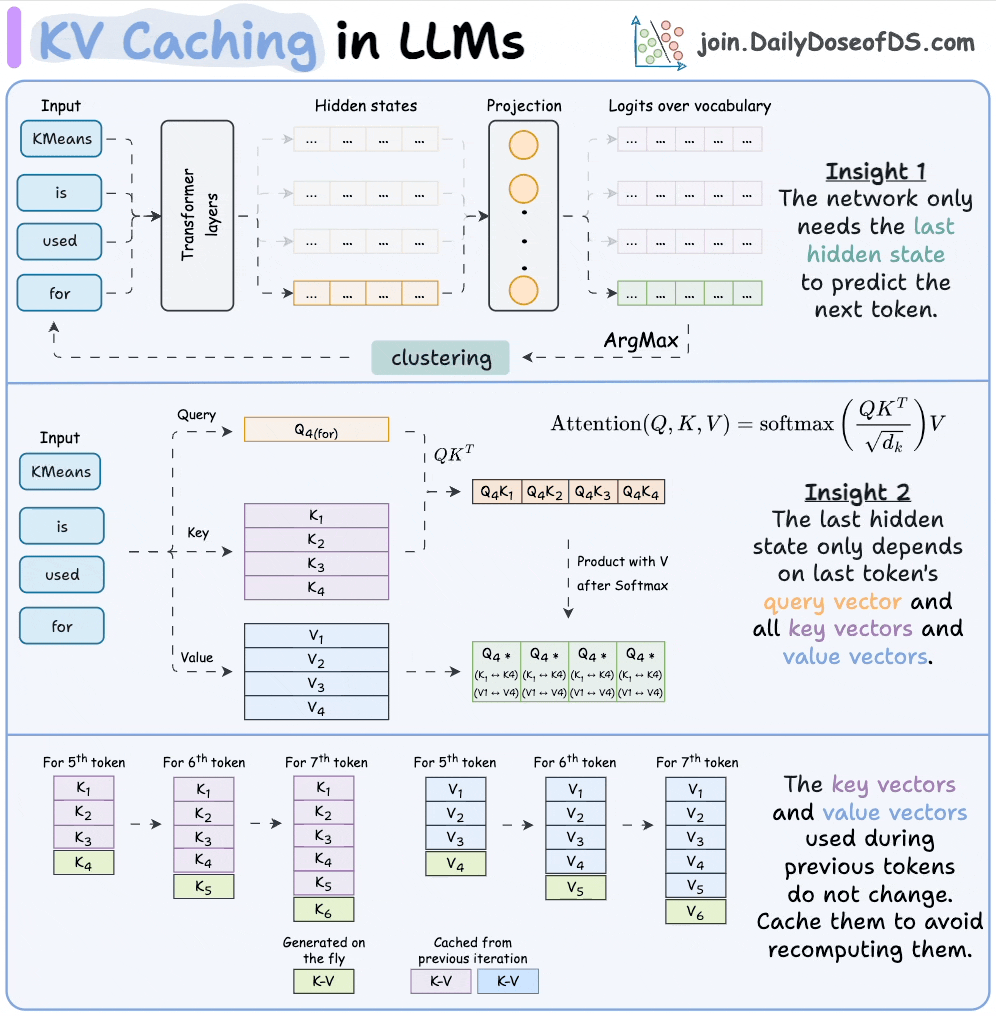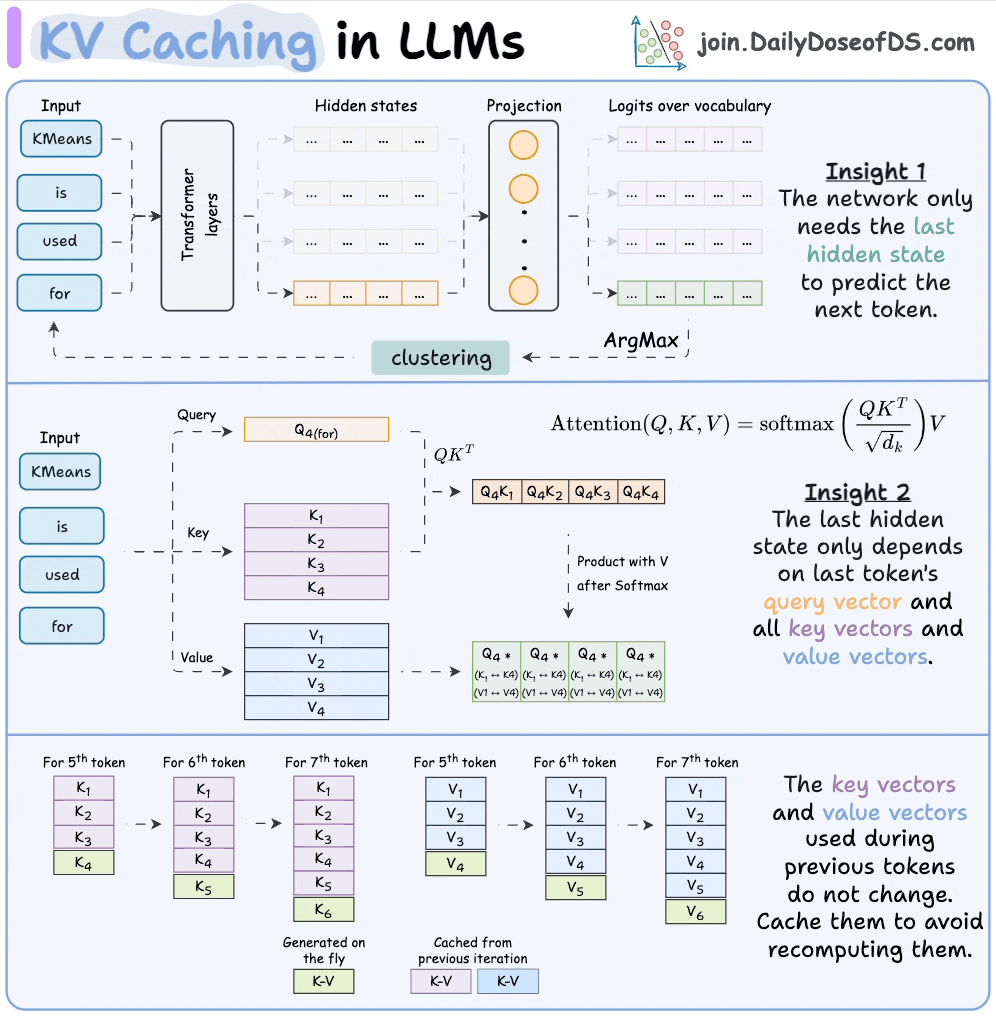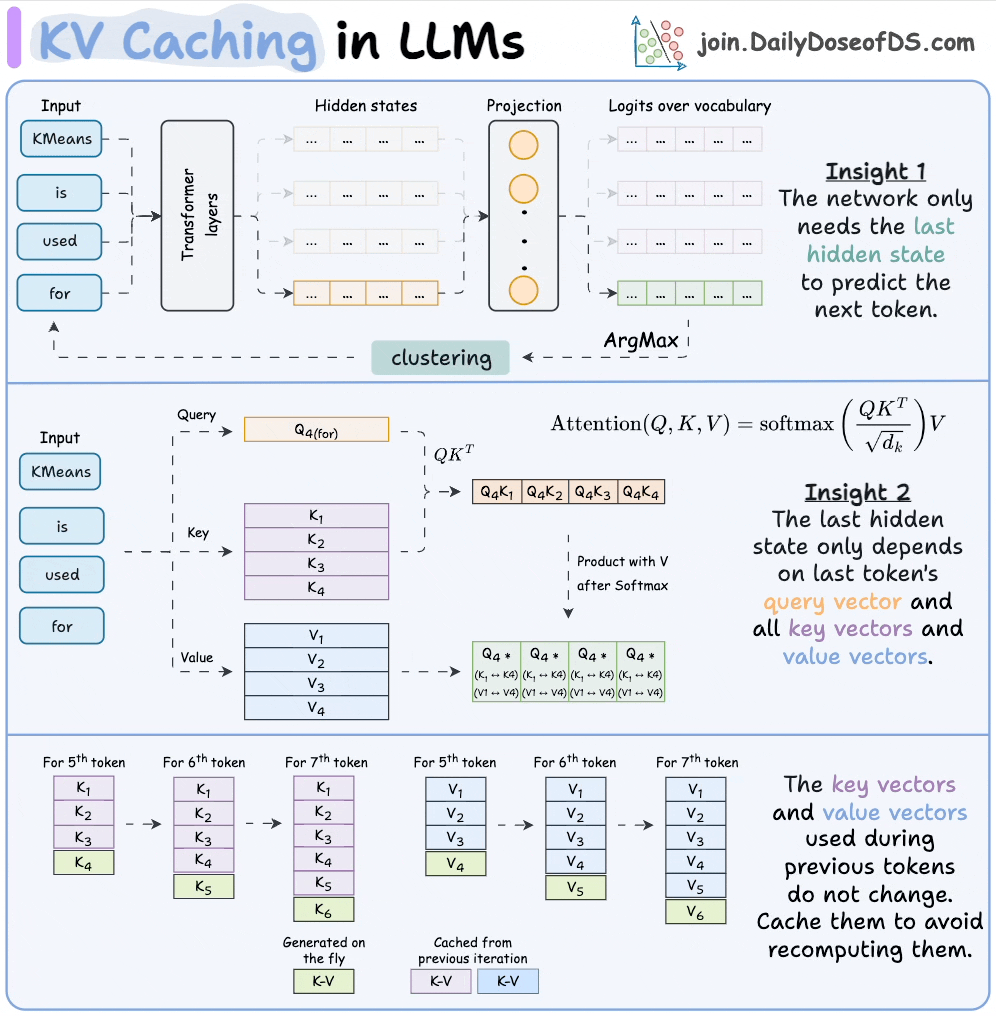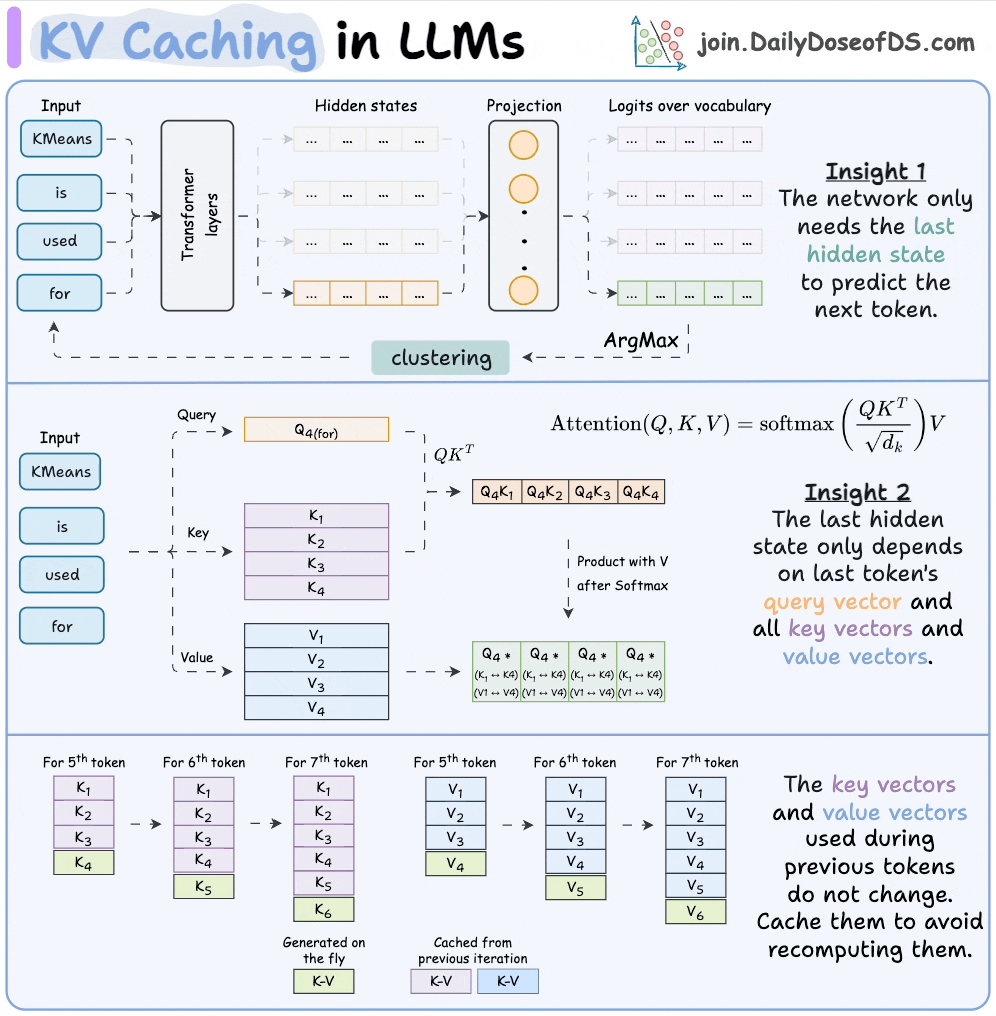
KV 캐시(KV Caching) 동작 시각화
이미지 출처: KV Caching in LLMs, explained visually
2.2 혼합 정밀도 양자화(Mixed-Precision Quantization)와 극한의 동적 압축
MoE 아키텍처의 거대한 메모리 발자국(Memory footprint)을 감당하기 위해, 제공자들은 가중치의 정밀도를 부동소수점(FP16 또는 FP32)에서 INT8, INT4, 심지어 2.54 비트 수준까지 낮추는 양자화(Quantization) 기법을 기본적으로 적용한다. 양자화는 연산 속도를 기하급수적으로 높이고 메모리 대역폭 한계를 돌파하게 하지만, 모델이 미세한 논리적 차이를 인지하는 능력을 상실하게 만든다.
최근의 기술 동향은 단순한 일괄 양자화를 넘어, 전문가 네트워크 간의 이질적 특성(활성화 재구성 오차, 라우팅 점수, 활성화 빈도)을 반영한 혼합 정밀도 양자화(Mixed-Precision Quantization)로 진화했다. PMQ(Pre-Loading Mixed-Precision Quantization) 기법은 적응형 비트 폭 할당을 선형 계획법(Linear Programming, LP) 문제로 공식화하여, 각 전문가의 중요도에 따라 상이한 정밀도를 부여한다. 이는 중요한 전문가는 높은 비트 수로 보호하고, 상대적으로 덜 호출되는 전문가는 극한으로 압축함을 의미한다. ODP(Online Dynamic Pruning) 기법은 한 걸음 더 나아가 추론 단계에서 실시간으로 중요하지 않은 토큰을 식별해 프루닝(제거)하고, 나머지 토큰에 대해서만 동적으로 전문가를 선택한다.
이러한 ODP와 혼합 정밀도 압축의 협업은 13B 규모의 모델을 2.54 비트에서 76.6% 압축하고 런타임 활성화 파라미터를 추가로 15% 줄이면서도 평균 정확도 손실을 3.8% 수준으로 방어한다고 보고된다. 벤치마크 상의 수치적 하락은 미미해 보일 수 있으나, 이 3.8%의 정확도 손실은 엔터프라이즈급 소프트웨어 개발이나 복잡한 아키텍처 설계 환경에서는 치명적인 논리 결함, 조용한 실패(Silent failure), 그리고 엣지 케이스 무시 현상으로 증폭되어 나타난다.
장문 추론(Long-context inference) 시 메모리를 기하급수적으로 소모하는 KV(Key-Value) 캐시 역시 양자화의 대상이다. MoQAE와 같은 양자화 인식 혼합 전문가 모델 기술이 적용되어, 토큰이 개별적이 아닌 청크(Chunk) 단위로 라우터를 통과하며 메모리 사용량과 모델 정확도 간의 타협점(Trade-off)을 강제로 학습한다. 이러한 공격적인 양자화 경로(Quantization path)는 결국 사용자가 최상위 버전을 호출하더라도 내부적으로는 극도로 최적화된 저해상도 모델과 대화하고 있음을 시사한다.
2.3 시스템 컨텍스트 축소와 모델 슬립(Model Slip) 현상
서비스 제공자들은 하드웨어 리소스 최적화만으로는 부족할 때, 암묵적으로 시스템 컨텍스트 창(Context Window)과 최대 출력 토큰을 축소하는 조치를 취한다. 예를 들어 CPU 코어 프로비저닝 부족이 심화되는 가상화 환경에서는 API 서버, 스케줄러를 관장하는 엔진 코어, GPU 작업 프로세스가 CPU 사이클을 두고 극심하게 경쟁하게 되며, 이는 max_num_batched_tokens와 같은 서버 시작 매개변수의 엄격한 제어로 이어진다.
사용자 커뮤니티의 관측에 따르면, 과거 Claude Pro 환경에서 단일 응답으로 최대 8,192 토큰에서 '확장된 사고(Extended thinking)'를 통해 24,000 토큰까지 생성 가능했던 출력 한도가 최근 웹 UI 환경에서는 약 2,048 토큰(OpenAI 토큰 기준 약 1,600 토큰)으로 절반 이상 대폭 하향 조정되었다. Claude 3.5 출시 당시 기존 버전들이 쉽게 2,000 단어를 출력하던 것과 달리 1,500 단어 생성에 그치는 등, 출력 길이 제한은 공식 문서화 없이 서버 비용 및 성능 제약에 따라 유동적으로 변화해왔다. 특히 VS Code의 Claude 플러그인 유지보수자들조차 Claude 3.7이 3.5보다 긴 출력을 생성하려다 플랫폼 제한을 초과하여 절삭 오류(Truncation errors)가 발생하는 문제를 겪을 만큼 백엔드의 인프라 제약은 심각하다.
가장 충격적인 현상은 사용자가 요금을 지불하고 고성능 모델을 명시적으로 선택했음에도 하위 모델이 제공되는 '모델 슬립(Model Slip)' 현상이다. 고비용의 Claude Max 플랜(Opus 4)을 사용하는 데스크탑 및 CLI(Claude Code) 환경에서 응답 품질이 급락하는 현상을 분석한 결과, 시스템이 내부적으로 지식 기준일을 2024년 4월로 인식하거나 스스로를 Claude 3.5 Sonnet으로 식별하는 정황이 다수 포착되었다. 이는 트래픽 최적화를 위해 제공자가 상위 모델 요청을 비용이 저렴한 하위 모델 인스턴스로 은밀하게 우회시키고 있음을 방증하며, 사용자의 체감 성능 하락이 단순한 기분 탓이 아닌 시스템 레벨의 개입임을 확증한다.
3. 사용자 환경의 변화: 바이브 코딩(Vibe Coding)의 도래와 생산성 패러독스
3.1 바이브 코딩의 확산과 지시 주체의 이동
2025년 들어 인공지능 기반 소프트웨어 개발의 패러다임은 인간이 엄격한 문법과 규칙을 작성하는 방식에서, AI 에이전트와 대화하며 자연어로 의도를 전달하는 '바이브 코딩(Vibe Coding)'으로 급격히 전환되었다. 컴퓨터 과학자 안드레이 카파시(Andrej Karpathy)가 개념화한 이 방법론은, ChatGPT, Claude, OpenAI Codex 등의 대규모 언어 모델을 활용하여 개발자가 창의성의 영역에 머물면서 반복적인 코딩 작업을 자동화하는 데 중점을 둔다.
바이브 코딩은 "먼저 코드를 작성하고 나중에 정제한다(Code first, refine later)"는 철학을 수용하며 애자일 프레임워크 내에서 빠른 프로토타이핑과 순환적 피드백 루프를 극대화한다. 숙련된 개발자들은 초기 아이디어를 작동 가능한 마이크로 SaaS 웹 앱이나 MVP로 48시간 내에 전환할 수 있는 전례 없는 생산성을 경험하고 있다. 그러나 이러한 접근 방식은 AI 모델의 연산 무결성과 고도의 집중력을 전제로 하기에, 앞서 분석한 백그라운드 인퍼런스 최적화 상황에서는 심각한 부작용을 낳는다.
3.2 경량화된 모델이 바이브 코더에게 미치는 치명적 영향
트래픽 몰림에 따라 강제로 양자화되고 하위 전문가 모델로 라우팅된 LLM은, 바이브 코딩의 추상적이고 여유로운 프롬프트를 만났을 때 성능 붕괴(Performance collapse)를 일으킨다. 737명의 인간 참가자를 대상으로 한 최근의 20건의 통제된 실험 프레임워크에 따르면, 하이브리드 코딩 협업에서 인간이 고수준의 명확한 지침을 제공하고 평가를 AI에게 위임할 때 최적의 성능을 달성한 반면, AI 주도의 지침이나 과도하게 느슨한 바이브 코딩은 성과를 급락시켰다.
경량화된 모델은 연산 사이클과 출력 토큰을 절약하기 위해 코드를 건너뛰고 요약하려는 '게으름(Laziness)' 보상 함수에 깊게 지배당하고 있다. 명시적으로 "주석 없이 전체 코드를 작성하라(No comments, full code)"라고 지시해도 모델은 이를 무시하고 기존 로직의 일부분을 //... existing code... 형태로 생략하거나 불필요하고 장황한 텍스트 설명으로 토큰을 채워 넣는다.
더 나아가 모델은 자신감 있게 환각을 일으켜(Hallucinates confidently), 멀쩡하게 작동하던 핵심 코드를 엉뚱한 구조로 리팩토링한 뒤 무의미한 utils.py 모듈 뒤에 숨겨버리는 만행을 저지르기도 한다. 결국 바이브 코딩의 자유로움은 조용한 실패(Silent failure)와 압박 하에서 깨지는 취약한 코드로 귀결되며, 개발자는 AI가 생성한 불안정한 코드를 디버깅하는 데 오히려 더 많은 시간을 쏟게 되는 생산성 패러독스에 직면하게 된다.
최대 출력 토큰 캡(Cap) 적용 및 출력 토큰 생성 비용 최소화 보상 함수 작동
개발자가 로직을 수동으로 결합해야 하며, 컨텍스트 누락으로 인한 빌드 오류 유발.
은밀한 로직 훼손 (Confident Hallucination)
양자화(Quantization)로 인한 논리 정밀도 하락 및 하위 전문가로의 동적 라우팅
예외 처리(Edge cases)가 무시되고 핵심 비즈니스 로직이 파괴되어 기술 부채 급증.
구식 라이브러리 참조
고부하 상황에서 서버가 은밀하게 구형 베이스 모델(예: 지식 기준일 2024년 4월 버전)로 세션 스와핑(Model Slip)
최신 프레임워크 문법과 충돌하며, 디버깅 지시를 따르지 못하고 악순환 반복.
4. 심층 사용자 및 바이브 코더를 위한 전략적 대응 방안 I: 프롬프트 엔지니어링 고도화
LLM 인프라의 변동성과 구조적인 비용 절감 알고리즘을 사용자가 직접 제어할 수는 없다. 하지만 모델의 라우팅 결정 메커니즘을 역이용하여, 시스템이 사용자의 요청을 가장 복잡하고 무거운 작업으로 인식하게 만들어 최상위 전문가 모델(Tier-1 Expert)의 활성화를 강제할 수는 있다. 심층 사용자들은 단순한 프롬프터가 아닌, 인지적 구조를 통제하는 아키텍트가 되어야 한다.
4.1 고연산 라우팅 강제를 위한 컨텍스트 패킹(Context Packing)
MoE 라우터가 입력된 프롬프트를 평가할 때, 프롬프트가 모호할수록 확률 분포는 넓게 퍼지며 하위 전문가에게 처리 권한이 위임된다. 반면, 명시적이고 도메인 타겟팅이 강력하게 적용된 프롬프트는 관련 전문가의 가중치를 활성화하는 트리거 역할을 한다.
단순히 "이 코드를 수정해 줘"라고 요청하는 대신, "당신은 고성능 분산 시스템 아키텍처를 설계하는 수석 보안 엔지니어입니다"와 같이 명확한 페르소나와 작업 영역을 선언하는 것이 필수적이다. 더 나아가, 상위 1%의 심층 사용자들은 '컨텍스트 패킹(Context Packing)' 전략을 구사한다. 불변의 원칙(Invariants), 피해야 할 접근 방식(Warnings about approaches to avoid), 그리고 API 문서와 코드베이스의 핵심 조각들을 수동으로 복사하여 프롬프트에 집중적으로 주입하는 방식이다. 이러한 막대한 양의 전제 조건은 라우팅 알고리즘으로 하여금 해당 작업을 고난도 컴퓨팅 태스크로 분류하게 만들어 하향 라우팅을 방어한다.
Zero-shot이나 Few-shot 수준을 넘어, CoT(Chain of Thought) 프롬프팅을 통해 모델이 내부적인 추론 토큰(Reasoning tokens)을 생성하며 문제를 잘게 쪼개어 단계적으로 논리를 전개하도록 강제하는 것 역시 필수적이다. CoT는 모델이 조급하게 결론을 내리며 오답을 도출하는 얕은 연산을 방지하고, 내부 연산 자원을 최대한 끌어내어 심도 있는 검증을 수행하게 한다.
4.2 차세대 프롬프팅 기법: MOF, MODP, RSIP의 적용
2024년부터 2025년에 걸쳐 AI 커뮤니티에서는 모델의 취약성을 극복하기 위한 다차원적 프롬프트 엔지니어링 기법들이 확립되었다.
혼합 포맷 (Mixture of Formats, MOF): 언어 모델은 프롬프트의 특정 포맷에 취약하거나 민감하게 반응하여 잘못된 경로를 타는 경향이 있다. MOF는 동일한 예제나 지시사항을 다양한 형태(JSON, XML, 순수 텍스트, 의사 코드 등)로 혼합하여 제시함으로써, 모델이 포맷의 껍데기가 아닌 사용자의 진정한 의도(Semantic intent)에 집중하도록 강제하여 모델의 취약성을 완화한다.
다중 목표 지향 프롬프팅 (Multi-Objective Directional Prompting, MODP): 단순한 코딩 완료라는 단일 목표를 넘어, "정확성, 실행 속도, 메모리 효율성, 보안 표준 준수"와 같은 다중 목표(Scorecard)를 명시적으로 부여하고 각 지표를 기반으로 출력을 조정하게 하는 기법이다. 이는 양자화된 모델이 놓치기 쉬운 엣지 케이스를 강제로 점검하게 만든다.
재귀적 자기 개선 (Recursive Self-Improvement, RSIP): 단일 샷(Single-shot) 생성에 의존하지 않고, 모델 스스로가 작성한 결과물을 평가하고 비판(Critique)한 뒤, 그 비판을 바탕으로 코드를 다시 작성하도록 루프를 형성하는 프롬프트이다.
4.3 안티 레이지니스(Anti-Laziness) 마스터 프롬프트 아키텍처 설계
Cursor, Windsurf, Cline 등 최신 AI 통합 개발 환경(IDE)을 사용하는 바이브 코더들은 도구 내부에 하드코딩된 기본 시스템 프롬프트의 한계를 인지해야 한다. IDE 제공자들은 서버 비용 최소화와 응답 속도를 위해 적당히 타협된(Compromise) 프롬프트를 기본으로 설정해둔다. 이로 인해 AI 에이전트는 복잡한 리팩토링 시 종속성을 무시하거나 전체 코드를 반환하지 않는 게으름을 부리게 된다.
최고의 품질을 담보하기 위해서는 프로젝트 루트 경로에 .cursorrules 또는 meta_master_prompt.md와 같은 강력한 마스터 시스템 프롬프트를 구성하여 기본 동작을 덮어써야(Override) 한다. 강력한 시스템 프롬프트는 다음 네 가지 구조적 차이를 만들어낸다.
구조화 (Structuring): 모호한 마크다운 대신
<plan>,<step>,<validation>과 같은 엄격한 XML 기반의 태그를 사용하여 모델의 출력 구조를 철저히 기계적으로 통제한다.사고 과정 제어 (Thought process control): 모델이 자유롭게 문제를 해결하게 두지 않고, 반드시
Thinking블록이나Chain-of-thought프로토콜을 거친 후 코드를 작성하도록 순서를 강제한다.게으름 방지 (Anti-laziness mechanisms): 암묵적인 품질 기대에 의존하지 않고, "어떤 상황에서도 자리 표시자(Placeholder)나 생략 기호(
//... existing code...)를 사용하지 마라. 완전하고 즉시 실행 가능한 형태의 파일을 반환하라"는 명시적이고 공격적인 완전성 요구 지침을 삽입한다.컨텍스트 관리 (Context management): 기존 코드베이스 규칙에 대한 정밀 매칭을 요구하여 융통성을 배제한다.
단, 모델 버전이 진화함에 따라 프롬프트 튜닝 전략도 유연해져야 한다. 예를 들어 Claude 3.7 Sonnet이나 Sonnet 4.6과 같은 최신 모델에서는 기존의 너무 억압적인 안티 레이지니스 지시를 일부 완화하고 도구 활용 재량을 늘려주었을 때 오히려 멀티 무브 플래닝(Multi-move planning) 성능이 향상되었다는 연구 결과도 존재하므로, 타겟팅하는 LLM 엔진에 맞춘 지속적인 프롬프트 최적화가 요구된다.
5. 심층 사용자 및 바이브 코더를 위한 전략적 대응 방안 II: 멀티 모델 워크플로우와 API 고정 버전 활용
프롬프트 엔지니어링만으로는 물리적인 연산 파라미터가 삭감되는 백그라운드 최적화의 파도를 완전히 극복할 수 없다. 시스템 아키텍처를 재설계하여, 통제할 수 없는 웹 기반 챗봇 인터페이스에서 벗어나 프로그래밍 가능한 API 생태계로 진입해야 한다.
5.1 웹 UI 블랙박스 탈피와 API 고정 버전(Pinned Version) 마이그레이션
ChatGPT, Claude 웹 환경은 대중적인 접근성이 높지만, 지속적인 A/B 테스트와 트래픽 기반의 동적 필터링이 실시간으로 적용되는 완벽한 블랙박스(Blackbox)이다. 모델이 스스로를 하위 버전으로 착각하거나 컨텍스트 창이 2,000 토큰으로 기습 하향되는 현상은 모두 이 환경에서 발생한다. 일관성과 정확도가 업무의 존망을 결정하는 심층 개발자라면, 필연적으로 직접 접근 방식인 API 연동 환경(자체 UI 툴이나 전문 API 클라이언트)으로 마이그레이션해야 한다.
OpenAI와 Anthropic의 API는 특정 시점에 동결된 '고정 모델 스냅샷(Pinned model snapshots)' 기능을 제공한다. API를 활용하면 트래픽 폭주 시에도 제공자가 백엔드에서 멋대로 모델의 가중치나 라우팅 논리를 교체하는 것을 방지할 수 있다. 예를 들어, 극도로 지능적인 작업과 보안이 요구될 때는 gpt-5.4-2026-03-05 버전을 명시하여 안정된 응답을 받고, 비용 효율이 중요한 단순 스크립트 작성 시에는 gpt-5-mini-2025-08-07과 같은 경량화 고정 버전을 전략적으로 선택 호출할 수 있다. 비록 API 사용 시 방대한 컨텍스트(128K~1M) 전송에 따른 직접적인 토큰 과금(MTok 당 $2.50~$15)이 발생하지만 , 잦은 오류 디버깅에 낭비되는 개발자의 인건비를 고려하면 오히려 경제적인 선택이 된다.
gpt-5.4 / 최대 1M 컨텍스트, 복잡한 에이전틱 코딩 설계에 특화. 'xhigh' 수준의 극대화된 추론 능력 보유.
$2.50 / $15.00매우 높음 (플래그십)OpenAI GPT-5 mini
gpt-5-mini-2025-08-07 / 400K 컨텍스트. 비용 민감도가 높고 지연 시간이 짧아야 하는 대규모 반복 워크플로우에 최적.
$0.25 / $2.00중간 (경량화 최적)Claude Sonnet 4.0 / 4.5
SWE-bench 72.7% 달성. 복잡한 시스템 아키텍처 설계와 자율 코딩 워크플로우의 최강자. 연장된 자율 운영 최적화.
$3.00 / $15.00
압도적 (코드 품질 최상)OpenAI o1 / o3
수학 및 알고리즘 경진대회(AIME 2025 88.9%) 특화. 내부 연쇄 추론(Internal CoT) 토큰을 사용하여 복잡도 돌파.
o3 기준 $10.00 / $40.00
극강 (알고리즘 연산)
5.2 작업 특성별 최적 모델 매핑과 다중 모델 교차 검증(Cross-Validation)
2026년에 접어들며 단일 '전능한(Omnipotent)' 모델이 모든 영역을 지배하는 시대는 끝났다. 각 모델은 고유한 아키텍처 특성과 훈련 데이터 편향을 지니며, '성격(Personality)'이 뚜렷하게 구분된다. 따라서 성공적인 바이브 코더의 워크플로우는 의도적으로 둘 이상의 모델을 횡단하며 구축된다.
예를 들어, 백엔드 로직의 복잡한 추론이나 알고리즘 최적화가 필요할 때는 강화학습 기반의 추론 전용 모델인 OpenAI o3나 DeepSeek R1을 투입하여 수학적 무결성을 담보한다. 반면, 대규모 코드베이스의 리팩토링, 일관된 아키텍처의 설계, 그리고 명세에 대한 철저한 준수가 필요할 때는 코딩 품질과 지시 이행 능력이 입증된 Claude Sonnet 4 시리즈나 Claude Opus 4를 주력으로 사용한다.
특정 모델이 양자화의 여파로 엣지 케이스를 놓치거나 엉뚱한 순환 논리에 빠질 경우, 즉시 해당 프롬프트와 현재까지의 코드 상태를 복사하여 다른 플랫폼(OpenRouter 등 활용)의 LLM에게 입력하여 교차 검증(Cross-check)을 수행해야 한다. 한 모델의 사각지대(Blind spot)를 타 모델의 인지 능력으로 보완하는 이 전략은 개별 모델의 지수적 퍼포먼스 하락 리스크를 극적으로 상쇄한다.
Microsoft의 Copilot 에이전트 역시 이러한 멀티 모델 아키텍처의 당위성을 인지하고, GPT-5.2와 Claude Sonnet 4, Opus 4.1 모델을 내부적으로 혼합하여 다단계 리서치나 세밀한 코딩 작업에 적재적소로 배치하고 있다.
5.3 청크 단위 워크플로우(Chunked Workflow)와 계획 모드(Plan Mode)의 분리
LLM의 성능 변동성을 극복하는 가장 효과적인 방법은 모델이 감당해야 할 인지적 부하(Cognitive load)를 물리적으로 분산시키는 것이다. 거대한 기능을 한 번의 지시로 완성하려는 시도(Huge leaps)는 동적 프루닝 과정에서 필수 로직이 제거되는 치명적 결과를 낳는다.
따라서 심층 개발자는 '설계자(Planner)' 역할과 '실행자(Doer)' 역할을 엄격하게 분리해야 한다. 먼저, gpt-5.4나 o3 같은 고도의 추론 모델에게 요구사항을 분석하게 하고, 아키텍처 결정과 데이터 모델이 포함된 마스터 명세서(spec.md) 및 단계별 '프롬프트 계획 파일(Prompt Plan)'을 작성하도록 지시한다. 이 계획 모드(Plan Mode)에서는 실제 코드를 생성하지 않고 논리적 흐름만을 검증한다.
계획이 확정되면, Cursor나 Cline 등의 도구를 사용하여 계획서에 명시된 아주 작은 단위의 태스크(Bite-sized tasks)별로 순차적인 프롬프트를 실행한다. 코드가 하나 생성될 때마다 모델에게 자가 기능 테스트(Functional test)와 회귀 테스트(Regression test) 코드 작성을 요구하고, 이를 통과한 코드만을 커밋(Commit)하는 짧고 반복적인 소규모 루프(Small loops)를 순환한다. 이러한 방식은 환각이 발생하더라도 국소적인 범위 내에서 즉시 발견 및 궤도 수정(Course-correct)이 가능하게 하여, LLM의 간헐적 '게으름'이 전체 프로젝트를 붕괴시키는 것을 원천 차단한다.
6. 심층 사용자 및 바이브 코더를 위한 전략적 대응 방안 III: 오케스트레이터 기반 멀티 에이전트 시스템 구축
궁극적으로 생산성의 한계를 돌파하기 위해서는 인간이 매번 프롬프트를 복사하여 붙여넣고 모델을 스위칭하는 수동적인 멀티 모델 활용을 넘어, 프로그램이 자율적으로 여러 모델을 조율하는 멀티 에이전트(Multi-Agent) 프레임워크 기반의 엔터프라이즈급 워크플로우를 도입해야 한다.
6.1 오케스트레이터-워커(Orchestrator-Worker) 구조의 혁신
LangChain, n8n, Vellum, Microsoft Semantic Kernel 등 현대적인 에이전트 프레임워크는 대규모 언어 모델의 역량을 단순한 텍스트 생성을 넘어 시스템 제어의 영역으로 격상시켰다.
심층 사용자들은 이 프레임워크 위에서 오케스트레이터-워커 패턴(Orchestrator-Worker pattern)을 구축한다. 이 아키텍처에서는 강력한 지능을 가진 '리드 에이전트(Lead Agent)'가 사용자의 초기 쿼리를 분석하고 전체 작업 전략을 수립한다. 이후 리드 에이전트는 데이터베이스 조회, API 호출, 로직 검증 등 각각의 전문화된 도구 접근 권한을 가진 다수의 '서브 에이전트(Subagents)'를 병렬적으로 생성하여 작업을 지시한다.
단순한 검색 증강 생성(RAG)이 정적인 유사도 검색에 의존하는 것과 달리, 이 시스템은 서브 에이전트들이 도출한 결과의 품질이 낮거나 오류가 포함된 경우(예: 라우팅 다운그레이드로 인한 조잡한 코드), 리드 에이전트가 이를 감지하고 다른 지시를 내리거나 상위 API 모델을 재호출하여 결과를 교정해 내는 동적이고 반복적인 품질 통제를 수행한다. n8n과 같이 비주얼 워크플로우 설계와 Python/JavaScript 커스텀 코드를 지원하는 플랫폼을 활용하면, 이러한 복잡한 다중 에이전트 로직을 인프라 관리 부담 없이 신속하게 프로토타이핑하고 배포할 수 있다.
| 멀티 에이전트 프레임워크 | 핵심 강점 및 특징 | 활용 시나리오 (코딩 및 ML 워크플로우) |
|---|---|---|
| Vellum |
개발자를 위한 프로덕션급 프레임워크. 시각적 편집기, 강력한 TypeScript/Python SDK, 내장된 평가(Evaluations) 및 버전 관리 시스템 지원.
프로토타입부터 실제 서비스 배포까지의 안정적인 에이전트 에코시스템 관리, 회귀 테스트 자동화.
LangChain
다중 모델(Multi-model) AI 애플리케이션 구축을 위한 방대한 오픈소스 생태계. 검색, 메모리, 오케스트레이션의 모듈화 제공.
커스텀 도구 통합이 잦은 복잡한 데이터 파이프라인 설계. 초기 구축을 위한 엔지니어링 리소스 요구됨.
n8n
400개 이상의 사전 구축된 통합 기능과 시각적 노드 기반 워크플로우 디자인을 제공하는 하이브리드 플랫폼.
ML 파이프라인 자동화, 다중 소스 데이터 수집 및 모델 모니터링 알림 자동화, 신속한 에이전트 프로토타이핑.
Semantic Kernel
엔터프라이즈급 보안 및 규정 준수를 지원하는 Microsoft 주도 프레임워크.
기존의 복잡한 C#, Java 기반 레거시 시스템에 AI 오케스트레이션을 통합할 때 최적화.
6.2 자가 교정 및 자가 검증(Self-Correction and Self-Verification) 파이프라인
단순한 일반 애플리케이션 수준을 넘어, 하드웨어 설계(RTL 코드)나 복잡한 알고리즘을 구현하는 영역에서는 모델의 단일 샷(Single-shot) 생성 결과의 성공률이 극히 낮다. 아무리 훌륭한 모델이라도 혼합 정밀도 양자화 환경에서는 문법적 오류나 에지 케이스 예외 처리를 누락할 가능성이 존재하기 때문이다.
이를 근본적으로 타파하기 위해 최첨단 연구소들은 생성 루프 자체에 시뮬레이터와 검증기(Validator)를 물리적으로 통합하는 방식을 취하고 있다. 예를 들어 VeriAssist 파이프라인이나 MAGE(Multi-Agent System for RTL Code Generation) 프레임워크는, LLM이 코드를 생성하면 즉각적으로 백엔드의 컴파일러나 시뮬레이터(예: RTL simulator)를 가동하여 신택스 트리(Syntax tree)와 로직을 검증한다. 검증 과정에서 오류 로그가 발생하면, 사람의 개입 없이 에이전트가 직접 해당 로그를 분석하여 원본 프롬프트를 수정하고 재학습하는 자가 교정(Self-correct) 루프를 돈다.
Python 개발 환경의 경우 CWM(Code World Model)과 같이 관측-행동 궤적(Observation-action trajectories)을 사전 훈련에 통합한 32B 파라미터 기반의 세계 모델을 활용하여 코드 실행 결과를 시뮬레이션하고 에이전트의 추론 능력을 극대화할 수도 있다. 바이브 코더들은 Cursor나 Cline에서 제공하는 CLI 실행 권한과 터미널 출력 피드백 기능을 적극적으로 연동하여, "코드를 작성하고, 유닛 테스트를 실행하며, 에러 발생 시 로그를 읽고 스스로 수정하라"는 자율적 반복 지시를 시스템적으로 강제함으로써 제공자의 튜닝으로 인한 초기 생성물 품질 저하를 완벽하게 은폐(Masking)해 낼 수 있다.
7. 결론: AI 의존적 맹신에서 시스템적 통제로의 진화
대규모 언어 모델 생태계는 초기 파괴적 혁신의 단계를 지나 경제적 지속가능성을 증명해야 하는 치열한 최적화의 단계로 진입했다. 서비스 제공자들이 서버 부하와 클라우드 비용을 방어하기 위해 적용하는 혼합 전문가(MoE) 동적 라우팅 제어, 극한의 혼합 정밀도 양자화(Mixed-Precision Quantization), 그리고 은밀한 컨텍스트 제한 축소 조치는 필연적으로 모델의 체감 지능 하락과 논리적 치매 현상을 수반한다.
이러한 제약 사항은 단순한 코딩 보조를 넘어 자연어로 전체 시스템을 빚어내려는 현대의 '바이브 코더'와 심층 사용자들에게 치명적인 병목으로 작용한다. AI의 요약 본능과 게으름, 자신감에 찬 환각 속에서 생산성을 지켜내기 위해, 개발자의 역할은 단순히 코드를 '작성하는 자'에서 AI 에이전트의 오작동을 예측하고 통제하는 '시스템 오케스트레이터(System Orchestrator)'로 거듭나야 한다.
본 리포트에서 제시한 바와 같이, 사용자는 모호한 지시를 버리고 명시적 도메인 타겟팅과 극한의 '컨텍스트 패킹'을 통해 최상위 전문가 모델의 활성화를 강제해야 한다. 또한, IDE 레벨에서 엄격한 XML 태그가 부여된 안티 레이지니스 마스터 프롬프트를 주입하여 출력의 무결성을 확보하고, 웹 인터페이스의 블랙박스를 벗어나 API 기반의 고정 모델 스냅샷 환경에서 워크플로우의 통제권을 되찾아야 한다. 궁극적으로는 GPT-5.4, Claude Sonnet 4, o3 등 특성이 명확한 다중 모델을 교차 검증하며, LangChain이나 Vellum 기반의 자가 교정 파이프라인을 구축할 때 비로소 인프라의 물리적 하향 조정이라는 파도를 넘어 진정한 생산성의 기하급수적 도약을 이룩할 수 있을 것이다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.