


Jetson은 엣지 AI·로보틱스를 위한 NVIDIA 임베디드 컴퓨팅 플랫폼으로, 카메라/센서 입력을 GPU로 빠르게 처리해 현장에서 바로 추론·제어까지 묶어낸다.
핵심 가치는 저전력 대비 높은 GPU 가속, CUDA 중심 생태계(라이브러리·툴·최적화), 비전 파이프라인(카메라/인코딩/추론) 통합이다.
라인업은 입문(Nano) → 중급(Xavier NX, Orin Nano/NX) → 고성능(AGX Xavier/AGX Orin)으로 올라가며, 전력·메모리·I/O·비용의 균형이 선택의 핵심이다.
소프트웨어는 JetPack(L4T) 위에 Ubuntu 기반 OS와 CUDA/cuDNN/TensorRT, 그리고 비전 스트리밍용 DeepStream, 로보틱스 연동(ROS/Isaac)이 층층이 올라간다.
개발은 보드 플래싱으로 시작해, 온디바이스 빌드 또는 크로스 컴파일을 선택하고, Docker로 재현성을 확보한 뒤 TensorRT/정밀도(FP16·INT8)로 성능을 끌어올린다.
전원·열·스토리지·카메라 호환·커널/드라이버 의존성을 초기에 점검해야 "돌아가긴 하는데 제품화가 어려운" 함정을 피할 수 있다.
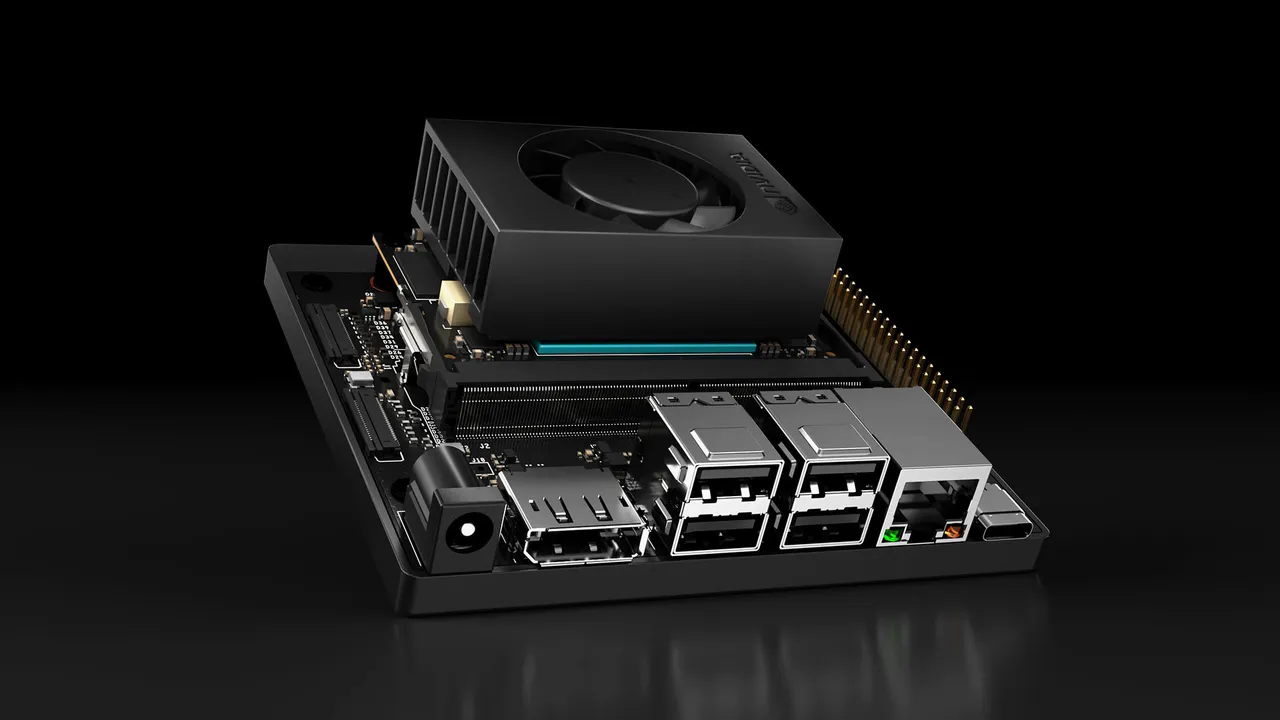
Jetson이 무엇인지와 핵심 가치
정의
Jetson은 엣지에서 AI 추론(필요하면 일부 학습/전처리)과 실시간 센서 처리, 로봇 제어를 수행하도록 설계된 NVIDIA의 임베디드 모듈/개발자키트 플랫폼
왜 Jetson을 쓰나(핵심 가치)
저전력 GPU 가속: 제한된 전력/공간에서 CPU만으로는 어려운 비전·딥러닝을 GPU로 처리
CUDA 생태계: CUDA, cuDNN, TensorRT 등으로 "같은 모델이라도 더 빠르게/덜 쓰게" 최적화할 수 있는 길이 열려 있음
카메라/센서 중심 설계: CSI 카메라, 하드웨어 인코더/디코더, 고속 I/O를 통해 영상 파이프라인을 엣지에서 완결하기 좋음
제품화 관점: 개발키트로 빠르게 검증하고, 모듈 기반으로 양산 설계로 넘어가기 쉬운 구조(단, 캐리어 보드/열 설계가 중요)
주요 하드웨어 라인업과 포지셔닝
Jetson Nano (입문)
용도: 학습/프로토타입, 간단한 비전 추론, 저비용 데모
특징: 성능은 낮지만 진입 장벽이 낮고 자료가 많음
Jetson Xavier NX (중급, 이전 세대 중심)
용도: 로봇/비전 제품의 중간급 요구(여러 스트림, 복수 모델 등)
특징: Nano 대비 큰 폭의 성능 향상, 다만 Orin 계열로 이동하는 흐름이 일반적
Jetson AGX Xavier (고성능, 이전 세대 플래그십)
용도: 고해상도·다중 카메라·복잡한 파이프라인
특징: 성능/전력/가격이 모두 "제품급"으로 올라감
Jetson Orin Nano (중급 입문~중급)
용도: Nano를 대체하는 느낌의 최신 라인, 더 실사용에 가까운 성능
특징: 전력/가격을 비교적 억제하면서도 최신 스택 활용
Jetson Orin NX (중급~고성능)
용도: 로봇/AMR/검사에서 "성능이 모자라기 시작하는 지점"을 넘기 위한 주력 옵션
특징: 성능 대비 전력 효율이 좋아 실전 선택 빈도가 높음
Jetson AGX Orin (고성능)
용도: 다중 카메라, 고속 추론, 복잡한 센서 융합, 대규모 파이프라인
특징: 성능 여유가 크지만 전원·열·비용·보드 설계 난도가 함께 상승
선택 시 고려 요소(체크 포인트)
성능: 목표 FPS/지연시간, 동시 카메라 수, 동시에 돌릴 모델 수(탐지+추적+분류 등)
전력/열: 팬리스 여부, 주변 온도, 히트싱크/팬 공간, 스로틀링 허용 여부
메모리: 모델 크기+배치+프레임 버퍼+여러 프로세스까지 합산(여유가 곧 안정성)
I/O: CSI 레인 수/지원 센서, USB3, PCIe(가속기·NIC·스토리지), 이더넷(1G/10G 필요)
비용: 모듈 단가뿐 아니라 캐리어 보드, 전원, 방열, 카메라, 스토리지까지 "BOM 전체"로 판단
수급/수명: 양산이면 산업용(industrial) 옵션과 장기 공급 정책 확인
소프트웨어 스택 개요
JetPack (L4T)
Jetson용 기본 배포판/SDK 묶음: OS 이미지, 드라이버, CUDA/가속 라이브러리, 개발 도구를 한 번에 제공
L4T(Linux for Tegra): Jetson 하드웨어에 맞춘 커널/드라이버/부트 체인 포함
OS 기반
Ubuntu 기반으로 개발 편의성이 높고, 일반 리눅스 툴체인/패키지 생태계를 활용 가능
핵심 가속 구성요소
CUDA: GPU 연산 기반
cuDNN: 딥러닝 연산(컨볼루션 등) 최적화 라이브러리
TensorRT: 추론 엔진 최적화(레이어 퓨전, 정밀도 변환, 커널 선택)로 지연시간/처리량 개선
비전/스트리밍
DeepStream: GStreamer 기반으로 다중 스트림 디코딩→전처리→추론→후처리→인코딩/전송 파이프라인 구성에 강함
로보틱스 연동
ROS/ROS 2: 센서 토픽, 내비게이션, SLAM, 제어 스택과 결합
Isaac(관련 SDK/툴): 로봇 애플리케이션 구성요소 및 가속을 활용하는 선택지(프로젝트 성격에 따라 채택)
개발 워크플로
플래싱(초기 셋업)
개발 PC(호스트)에서 JetPack 툴로 OS 이미지를 보드에 설치
제품화 단계에서는 커스텀 이미지(계정/키/패키지/서비스)로 재현 가능한 설치 흐름을 만드는 게 중요
빌드 전략: 크로스 컴파일 vs 온디바이스 빌드
크로스 컴파일(호스트 빌드): 대규모 C++ 프로젝트나 빌드 시간이 긴 경우 유리, 단 ABI/라이브러리 버전 정합이 관건
온디바이스 빌드: 환경 불일치가 줄고 디버깅이 단순, 대신 빌드 시간이 길고 저장공간/메모리 부담이 큼
실무 팁: 앱은 크로스, Jetson 의존성이 강한 부분(플러그인/드라이버 연동)은 온디바이스로 나누기도 함
컨테이너(Docker) 활용
JetPack 버전과 CUDA/TensorRT 버전을 "환경으로 고정"해 팀 개발·배포 재현성 확보
모델/파이프라인별로 이미지를 분리하면 롤백과 A/B 테스트가 쉬움
주의: 카메라/하드웨어 가속 접근 권한(디바이스 마운트, 런타임 설정)을 표준화해야 함
성능 최적화(현장 체감이 큰 순서로)
TensorRT 변환: 프레임워크 모델을 엔진으로 빌드해 추론 지연시간/처리량 개선
정밀도 최적화: FP16은 "대체로 안전한 가속", INT8은 "캘리브레이션/정확도 관리"가 필요하지만 이득이 큼
파이프라인 최적화: 디코딩/리사이즈/색변환/추론/후처리의 병목을 분리해 병렬화(스트림, 버퍼링, zero-copy 지향)
측정 기반 튜닝: "추론만 빠른데 전체 FPS는 그대로"가 흔하므로, end-to-end 지연시간을 기준으로 본다
대표 사용 사례
비전 기반 로봇
장애물 인지, 객체 추적, 도킹/피킹 등에서 카메라 입력과 실시간 제어를 한 장치에서 처리
스마트 카메라/감시
사람/차량 감지, 구역 침입, 군중 밀도 등 이벤트 기반 분석을 엣지에서 수행해 네트워크/서버 비용을 줄임
제조 검사(머신비전)
결함 검출, OCR, 치수/정렬 확인 등을 저지연으로 처리해 라인 속도를 맞춤
AMR/드론
센서 융합, 경량화된 SLAM/추론, 통신 장애 상황에서도 로컬 자율성을 확보
엣지 분석 단말
여러 카메라 스트림을 모아 로컬에서 추론하고, 결과만 클라우드로 보내 비용/지연을 줄이는 구조
장단점과 주의사항
장점
전력 대비 성능이 좋고, 비전/AI 파이프라인 구성 요소가 잘 갖춰져 "처음부터 끝까지" 이어 붙이기 쉽다
TensorRT/DeepStream 등으로 제품 수준의 최적화 루트를 확보하기 좋다
개발키트→모듈→양산으로 이어지는 흐름을 전제로 한 생태계가 있다
단점/주의
전원/열 설계가 성공의 절반: 스로틀링이 걸리면 성능이 불안정해지고, 팬/히트싱크 설계가 제품 경험을 좌우함
저장공간: JetPack+Docker+모델+로그가 쌓이면 금방 부족해지므로 SSD/NVMe 고려가 안전
카메라/CSI 호환: 센서 드라이버, 디바이스 트리, 레인/클록 제약이 있어 "꽂으면 된다"가 아닌 경우가 많다
드라이버/커널 의존: 커널 버전과 NVIDIA 드라이버 스택 결합도가 높아, 임의 업그레이드가 리스크가 될 수 있음
장기 공급: 양산/산업용은 수급 기간, 대체 가능성, 모듈 EOL 정책을 먼저 확인해야 한다
보안/OTA: 현장 장비는 업데이트 체계(서명, 롤백, 장애 복구)와 키/인증서 관리까지 설계 범위에 넣어야 함
빠른 시작 체크리스트(구매 후)
준비물
Jetson 개발자키트(또는 모듈+캐리어), 안정적인 전원 어댑터, 충분한 방열(기본 쿨러 포함 여부 확인)
저장장치(필요 시 NVMe/SSD), 모니터/키보드(초기 설정용), 이더넷 또는 Wi‑Fi(보드 지원 확인)
카메라를 쓸 계획이면 호환 CSI 카메라(또는 USB 카메라)와 케이블
기본 설정
JetPack/L4T 플래싱 후 초기 부팅, 계정 생성, 시간/네트워크 설정
전력 모드/클럭 정책 확인(성능 측정 전 "현재 모드가 무엇인지" 고정)
스왑/로그/도커 데이터 경로 등 저장공간 정책을 초기에 정리
테스트 예제 실행
GPU 동작 확인: CUDA 샘플 또는 간단한 추론 데모로 GPU/드라이버 정상 여부 점검
카메라 확인: V4L2/가속 파이프라인로 프리뷰 및 FPS 확인
TensorRT/DeepStream 샘플: 단일 스트림→다중 스트림 순으로 올리며 병목 지점을 파악
온도/스로틀링 확인: 장시간 부하 테스트로 클럭 유지 여부를 확인(제품화 리스크 조기 발견)
선정 가이드(질문 5개)
목표 입력은 무엇인가: 카메라 해상도/프레임, 스트림 수, 추가 센서(라이다/레이다/IMU) 유무는?
목표 성능은 무엇인가: 최소 FPS와 최대 허용 지연시간(end-to-end)은?
전력/열 제약은 무엇인가: 팬리스가 필수인가, 동작 온도 범위는 어디까지인가?
확장 I/O가 필요한가: CSI 레인 수, PCIe, 듀얼 이더넷/10G, 저장장치(NVMe) 요구는?
제품 조건은 무엇인가: BOM 상한, 생산 수량, 장기 공급/산업용 등급, OTA/보안 요구는?
용어 미니 사전(10개 내외)
JetPack: Jetson용 OS 이미지와 드라이버, CUDA/AI 라이브러리, 도구를 묶은 SDK
L4T: Jetson 하드웨어에 맞춘 Linux(커널/드라이버/부트 구성 포함)
CUDA: NVIDIA GPU에서 병렬 연산을 수행하기 위한 플랫폼/프로그래밍 모델
cuDNN: 딥러닝 핵심 연산을 GPU에서 빠르게 수행하도록 최적화한 라이브러리
TensorRT: 모델을 최적화된 추론 엔진으로 변환해 지연시간/처리량을 개선하는 런타임
DeepStream: 비디오 스트림 기반 AI 파이프라인(디코드/전처리/추론/인코드/전송)을 구성하는 SDK
CSI(MIPI CSI-2): 임베디드에서 흔히 쓰는 카메라 직결 인터페이스
FP16: 16비트 부동소수점 정밀도(대체로 정확도 손실이 적고 속도 이점이 큼)
INT8: 8비트 정수 정밀도(최대 성능 이점, 대신 캘리브레이션/정확도 관리 필요)
플래싱(Flashing): 보드에 OS/부트로더 등을 설치해 부팅 가능한 상태로 만드는 과정
스로틀링(Throttling): 온도/전력 제한으로 클럭이 내려가 성능이 감소하는 현상
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.