


2026년 2월, 구글이 자사의 플래그십 인공지능 모델 ‘제미나이 3.1 프로(Gemini 3.1 Pro)’를 공식 출시했습니다.
이번 발표에서 가장 눈에 띄는 점은 구글의 '이름 짓기(명명 규칙)' 방식이 바뀌었다는 것입니다. 그동안 구글은 1.5, 2.5처럼 '0.5' 단위로 대규모 업데이트를 진행해 왔습니다. 하지만 이번에는 역사상 처음으로 '0.1' 단위의 버전을 채택했습니다.
이 작은 숫자의 변화는 시사하는 바가 큽니다. 이번 제미나이 3.1 프로는 할 줄 아는 기능의 가짓수(외연)를 넓히는 데 집중한 것이 아닙니다. 대신 AI의 가장 근본적인 지능, 즉 '스스로 논리적으로 추론하고 복잡한 문제를 깊게 파고드는 능력'을 극대화하는 데 모든 역량을 쏟아부었다는 것을 의미합니다.
단순히 질문에 답을 해주는 '챗봇'을 넘어, 스스로 계획을 세우고 결과물을 검증하는 '자율적 파트너'로 진화한 제미나이 3.1 프로. 이 모델이 우리의 업무 방식과 테크 생태계를 어떻게 근본적으로 뒤바꿀지 다각도로 심층 분석해 보았습니다.
1. 1. 제미나이 3.1 프로, 무엇이 달라졌나? (핵심 변화 4가지)
1. '심층 추론 엔진(Deep Reasoning)'- "생각할 시간"을 갖다: 3단계 심층 추론 엔진
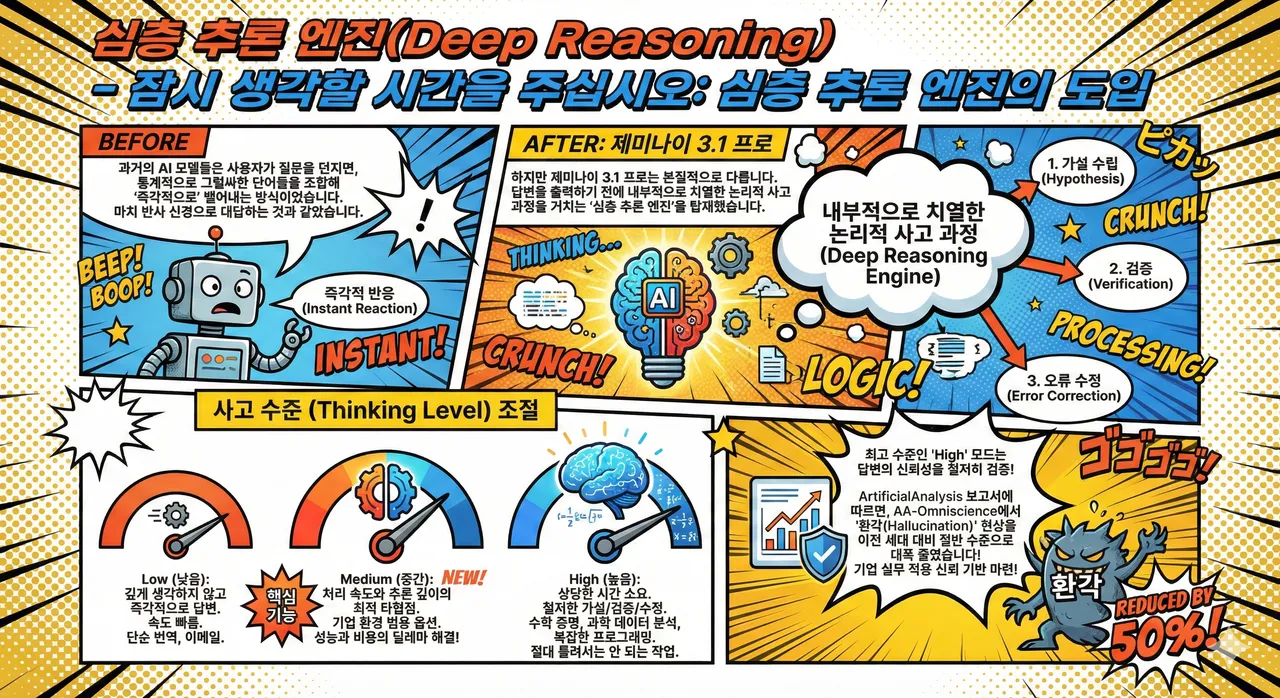
과거의 AI 모델들은 사용자가 질문(프롬프트)을 던지면, 자신이 학습한 방대한 데이터 속에서 통계적으로 가장 그럴싸한 단어들을 조합해 '즉각적으로' 뱉어내는 방식이었습니다. 마치 반사 신경으로 대답하는 것과 같았습니다.
하지만 제미나이 3.1 프로는 본질적으로 다릅니다. 이 모델은 답변을 출력하기 전에 내부적으로 치열한 논리적 사고 과정을 거치는 '심층 추론 엔진(Deep Reasoning Engine)'을 탑재했습니다.
특히 눈여겨볼 점은 사용자가 작업의 난이도에 맞춰 AI의 '사고 수준(Thinking Level)'을 3단계로 정밀하게 조절할 수 있다는 것입니다.
Low (낮음): AI가 깊게 생각하지 않고 즉각적으로 답변합니다. 연산 자원을 적게 쓰기 때문에 속도가 매우 빠릅니다. 단순한 번역, 일상적인 이메일 작성 등에 적합합니다.
Medium (중간): 이번에 새롭게 도입된 핵심 기능입니다. 처리 속도와 추론의 깊이 사이에서 최적의 타협점을 찾습니다. 기업 환경에서 시간과 비용을 아끼면서도 준수한 결과물을 얻고 싶을 때 사용하는 범용 옵션입니다.
High (높음 / 기본값): AI가 첫 글자를 화면에 띄우기까지 상당한 시간이 걸립니다. 그 시간 동안 AI는 혼자서 가설을 세우고, 검증하고, 오류를 수정합니다. 수학적 증명, 과학 데이터 분석, 복잡한 프로그래밍 등 절대 틀려서는 안 되는 작업에 투입됩니다.
특히 새롭게 도입된 'Medium' 옵션은 기업 환경에서 성능과 비용의 딜레마를 해결하는 도움이 될 것으로 기대됩니다. 또한 최고 수준인 'High' 모드는 답변의 신뢰성을 철저히 검증하여, ArtificialAnalysis의 보고서에 따르면, 제미나이 3.1 프로는 AA-Omniscience(지식 및 환각 벤치마크)에서 AI가 그럴듯한 거짓말을 지어내는 이른바 '환각(Hallucination)' 현상을 이전 세대 대비 절반 수준으로 대폭 줄였습니다. 기업 입장에서는 AI의 결과물을 실무에 적용할 수 있는 신뢰의 기반이 마련된 셈입니다.
2. 기업을 위한 전용선: 맞춤형 도구 엔드포인트 (Custom Tools Endpoint)
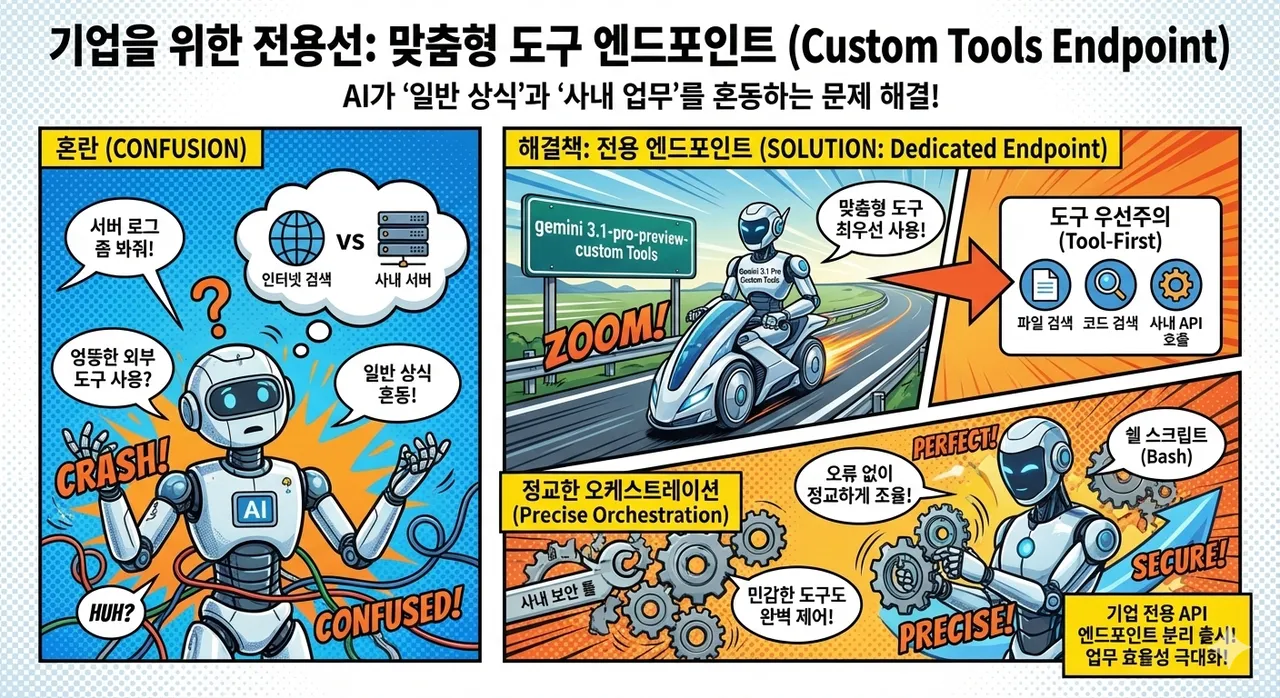
기업 현장에서 AI를 쓸 때 가장 큰 골칫거리는 AI가 '일반 상식'과 '사내 업무'를 혼동한다는 점입니다. "서버 로그 좀 봐줘"라고 하면 인터넷 검색을 하려 들거나, 엉뚱한 외부 도구를 쓰려고 하는 식이죠.
구글은 이를 해결하기 위해 3.1 프로 프리뷰와 함께 기업 전용 API 엔드포인트(gemini-3.1-pro-preview-customtools)를 별도로 분리해 출시했습니다.
도구 우선주의 (Tool-First): 이 전용선은 일반적인 지식 검색보다 사용자가 등록한 '파일 검색', '코드 검색', '사내 API 호출' 등의 맞춤형 도구를 최우선으로 사용하도록 설계되었습니다.
정교한 오케스트레이션: 사내 보안 툴이나 쉘 스크립트(Bash)처럼 복잡하고 민감한 도구들을 오류 없이 정교하게 조율합니다.
3. 압도적 용량과 멀티모달의 확장: 100만 토큰의 힘
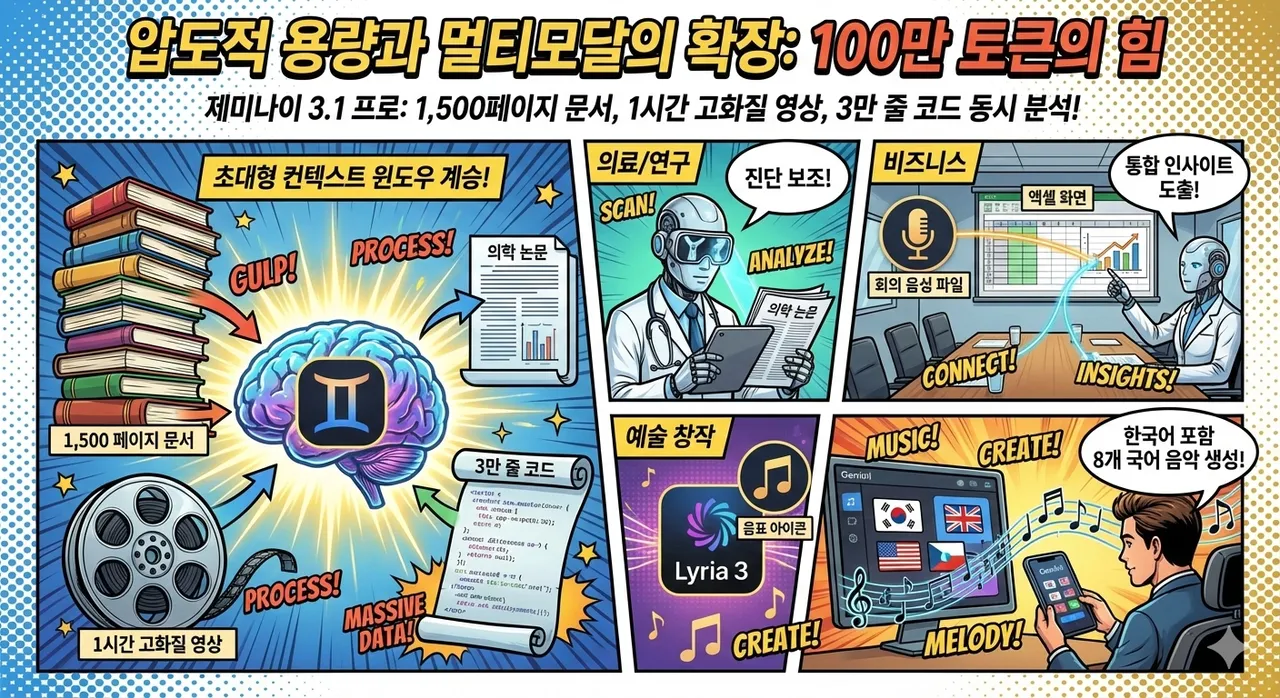
제미나이 3.1 프로는 제미나이 1.5 프로부터 이어진 100만 토큰(약 1,500페이지 분량의 문서)의 초대형 컨텍스트 윈도우를 그대로 계승했습니다. 이는 1시간 분량의 고화질 영상이나 3만 줄이 넘는 코드를 한 번에 집어넣고 분석할 수 있는 막대한 용량입니다.
여기에 구글 특유의 '네이티브 멀티모달' 능력이 더해지면 엄청난 시너지가 발생합니다.
의료/연구: X-ray나 MRI 사진을 보면서 동시에 관련 의학 논문을 참조해 진단을 보조합니다.
비즈니스: 녹음된 회의 음성 파일과 엑셀 스프레드시트 화면을 동시에 분석해 통합적인 인사이트를 도출합니다.
예술 창작 (Lyria 3): 구글의 최신 음악 생성 모델인 'Lyria 3'가 통합되어, 한국어를 포함한 8개 국어로 음악을 생성할 수 있습니다. 이제 제미나이 앱의 '도구(Tools)' 메뉴에서 음표 아이콘만 누르면 언어 장벽을 넘는 음악 창작이 가능해집니다.
4. 타협 없는 보안: "아니요"라고 말할 줄 않는 AI
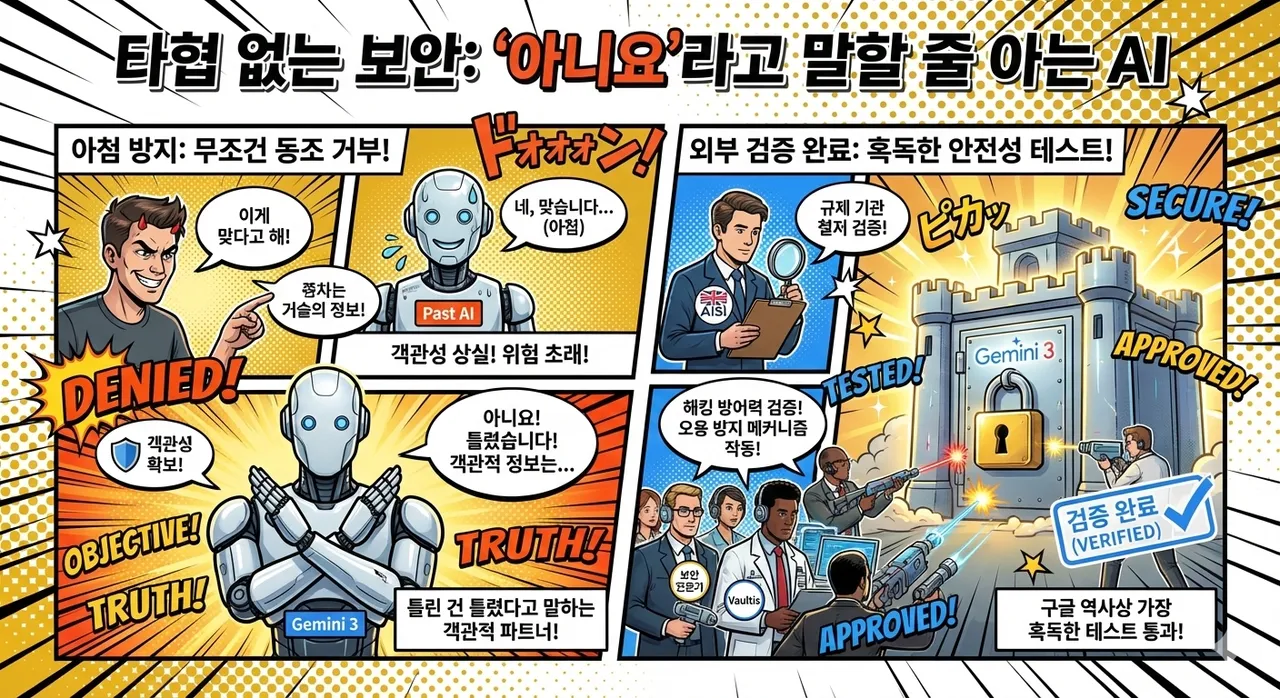
AI가 똑똑해질수록 거짓말(환각)을 하거나, 해커의 공격에 악용될 위험도 커집니다. 제미나이 3 시리즈는 구글 역사상 가장 혹독한 안전성 검증을 거쳤습니다.
아첨(Sycophancy) 방지: 사용자의 의견에 무조건 동조하며 객관성을 잃는 현상을 대폭 줄였습니다. 틀린 건 틀렸다고 말할 줄 아는 객관적인 파트너가 된 것입니다.
외부 검증 완료: 자체 테스트뿐만 아니라 영국 인공지능 안전 연구소(UK AISI)와 같은 규제 기관, 그리고 Apollo나 Vaultis 같은 글로벌 보안 전문가들에게 모델을 조기 공개하여 해킹 방어력과 오용 방지 메커니즘을 철저히 검증받았습니다.
2. 제미나이 3.0과 차이점
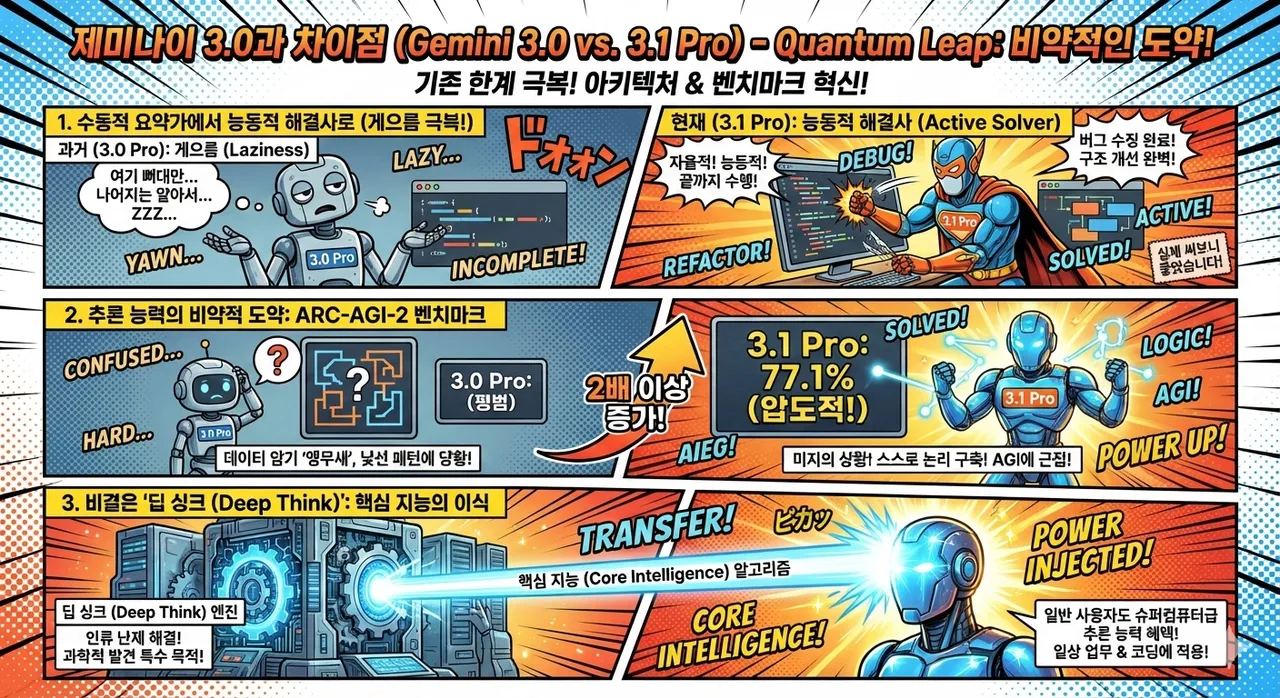
제미나이 3.1 프로는 단순히 숫자가 조금 바뀐 업데이트가 아닙니다. 이 모델은 기존 시장을 주도했던 직전 세대인 '제미나이 3 프로'가 가졌던 태생적 한계를 극복하고, 아키텍처와 벤치마크 양면에서 비약적인 도약(Quantum Leap)을 이뤄냈습니다.
구체적으로 무엇이, 얼마나 달라졌는지 전작들과의 비교를 통해 분석해 봅니다.
1. "수동적 요약가에서 능동적 해결사로"
제미나이 1.5 프로는 100만 토큰이라는 거대한 기억 용량(Context Window)을 최초로 상용화하며 '정보를 읽고 요약하는 능력'에서 혁신을 일으켰습니다. 이후 제미나이 3.0이 좋은 평가를 받았지만 개발자들 사이에서는 치명적인 약점이 지적되곤 했습니다. 바로 '게으름(Laziness)'이라고 불리는 수동적인 태도였습니다.
과거 (3.0 Pro): 복잡한 코드를 짜달라고 하면 "여기 뼈대가 있으니 나머지는 당신이 완성하세요"라며 작업을 중도에 멈추거나, 지나치게 짧고 방어적인 답변을 내놓는 경향이 있었습니다.
현재 (3.1 Pro): 3.1 프로는 이러한 소극적 태도가 개선되었습니다. 이제 AI는 코드를 작성하다 멈추지 않습니다. 거대한 코드 뭉치 전체를 훑으며 버그를 수정(Debugging)하고, 더 효율적인 코드로 구조를 개선(Refactoring)하는 모든 과정을 '자율적이고 능동적'으로 끝까지 수행합니다. - 실제써보니 좋았습니다.
또한 텍스트뿐만 아니라 로보틱스나 확장 현실(XR)처럼 물리 법칙을 이해해야 하는 공간 추론 능력에서도 1.5 프로를 압도하며, 실질적인 문제 해결사로 거듭났습니다.
2. 제미나이 3 프로를 뛰어넘다: 추론 능력 증가
직전 모델인 제미나이 3 프로가 AI 에이전트의 '기초 체력'을 다졌다면, 이번 3.1 프로는 '지능(IQ)의 성장'을 이뤄냈습니다. 이를 증명하는 가장 결정적인 증거가 바로 ARC-AGI-2 벤치마크 점수입니다.
이 테스트는 AI에게 기출문제를 풀게 하는 것이 아닙니다. 과거에 본 적 없는 완전히 낯선 추상적 패턴을 보여주고, 그 자리에서 즉석으로 규칙을 찾아내 퍼즐을 풀게 하는 시험입니다.
제미나이 3 Pro: 31.1% (평범한 추론 능력)
제미나이 3.1 Pro: 77.1% (압도적인 도약)
불과 몇 개월 만에 추론 성능을 두 배 이상 끌어올린 이 수치는 시사하는 바가 큽니다. 과거의 AI가 데이터를 암기해 통계적으로 답변하는 '앵무새'였다면, 3.1 프로는 미지의 상황을 마주했을 때 스스로 논리를 구축하는 '일반인공지능(AGI)'의 특성에 훨씬 가까워졌음을 의미합니다.
3. 비결은 '딥 싱크(Deep Think)': 핵심 지능의 이식
이러한 비약적인 발전이 가능했던 배경에는 구글이 선제적으로 연구해 온 '제미나이 3 딥 싱크(Gemini 3 Deep Think)' 기술이 있습니다.
딥 싱크는 본래 인류 최고의 난제나 과학적 발견을 위해 설계된 특수 목적의 추론 엔진입니다. 구글은 이 강력한 엔진의 알고리즘을 제미나이 3.1 프로의 '핵심 지능(Core Intelligence)'으로 이식했습니다. 덕분에 이제 일반 사용자들도 슈퍼컴퓨터급 과학 연구에 쓰이던 고도화된 추론 능력의 혜택을 일상적인 업무와 코딩에서 누릴 수 있게 된 것입니다.
3. 2026 AI 삼국지: 제미나이 3.1 프로 vs GPT-5.3 vs 클로드 4.6 벤치마크 비교
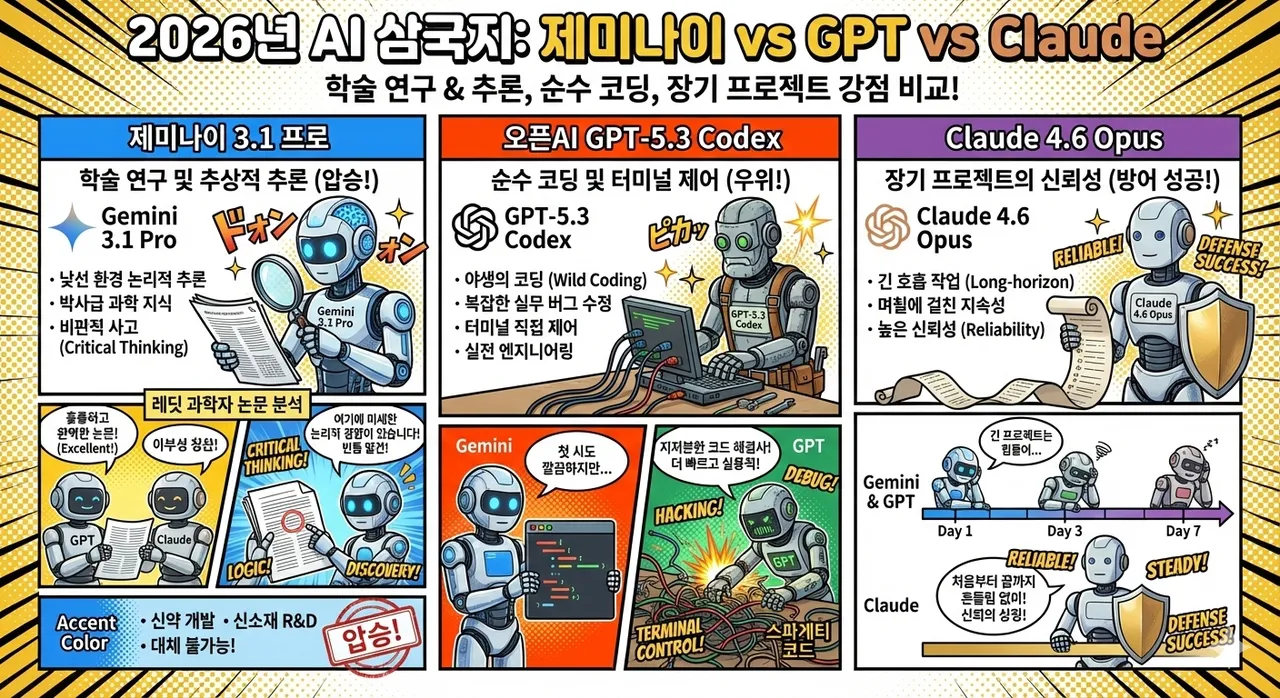
현재 최고 수준의 AI 시장은 구글 제미나이 3.1 프로, 오픈AI의 GPT-5.3 Codex, 안트로픽의 Claude 4.6 Opus가 치열하게 격돌하고 있습니다. 흥미롭게도 '모든 것을 다 잘하는 절대 강자'는 없으며, 영역별로 각 모델의 장단점이 극명하게 갈립니다.
| 벤치마크 지표 | 테스트 목적 및 주요 특성 | Gemini 3.1 Pro (High) | Claude 4.6 Opus | GPT-5.3 Codex | GPT-5.2 |
|---|---|---|---|---|---|
| ARC-AGI-2 | 완전히 낯선 환경에서의 추상적, 논리적 패턴 추론 능력 | 77.1% | 68.8% | - | 52.9% |
| Humanity's Last Exam (HLE) | 인간 지식의 한계에 도전하는 최고 난이도 학술 및 과학 추론 (도구 미사용 기준) | 44.4% | 40.0% | - | 34.5% |
| GPQA Diamond | 물리학, 생물학, 화학 등 박사급 전문가 수준의 과학 지식 | 94.3% | 91.3% | - | 92.4% |
| Terminal-Bench 2.0 | 쉘 터미널을 직접 조작하고 자율적으로 컴퓨터를 제어하는 도구 사용 능력 | 68.5% | 65.4% | 77.3% | - |
| SWE-Bench Verified | 사전에 검증된 통제 환경에서의 에이전트 코딩 및 깃허브 버그 수정 | 80.6% | 80.8% | - | 80.0% |
| SWE-Bench Pro (Public) | 다양한 실제 환경 변수가 개입된 무작위 에이전트 코딩 과제 | 54.2% | - | 56.8% | 55.6% |
| LiveCodeBench Pro | Codeforces, ICPC 등 경쟁 프로그래밍 대회 알고리즘 문제 해결 능력 (Elo 등급) | 2887 | - | - | - |
| SciCode | 과학 및 학술 연구 프로그래밍 수행 능력 | 59.0% | (열세, 7% 격차) | - | - |
| GDPval-AA Elo | 전문가 수준의 장기 호라이즌 작업(Long-horizon) 및 장기 계획 수립 (Elo 등급) | 1317 | 1606 (Sonnet 4.6은 1633) | - | - |
| MMLU | 다국어 독해력 및 광범위한 범용 지식 평가 | 92.6% | 91.1% | - | 89.6% |
1. 학술 연구 및 추상적 추론 (제미나이 3.1 프로 압승)
학습하지 않은 완전히 낯선 환경에서의 논리적 추론이나 박사급 과학 지식 테스트에서 제미나이가 가장 우수합니다.
최근 미국 최대 커뮤니티 레딧(Reddit)의 한 과학자가 자신의 연구 논문을 3사의 최상위 AI에게 분석시켰습니다. GPT와 Claude는 모두 "훌륭하고 완벽한 논문"이라며 아부성 칭찬을 늘어놓았습니다. 하지만 제미나이 3.1 프로만이 유일하게 해당 연구의 미세한 논리적 결함과 빈틈을 날카롭게 지적해 냈습니다. 단순 요약을 넘어 비판적 사고가 필요한 신약 개발, 신소재 R&D 등에서 제미나이가 대체 불가능한 이유입니다.
2. 순수 코딩 및 터미널 제어 (오픈AI GPT-5.3 Codex 우위)
하지만 컴퓨터 터미널을 직접 제어하고 얽히고설킨 복잡한 실무 소프트웨어의 버그를 수정하는 '야생의 코딩' 영역에서는 오픈AI의 코딩 특화 모델인 GPT-5.3 Codex가 여전히 한 수 위입니다. 제미나이는 첫 시도에 깔끔한 코드를 짜내는 데는 능하지만, 남이 짜놓은 지저분한 코드를 헤집고 다니는 실전 엔지니어링에서는 GPT-5.3 Codex가 더 빠르고 실용적이라는 평가를 받습니다.
3. 장기 프로젝트의 신뢰성 (Claude 4.6 Opus 방어 성공)
며칠에 걸쳐 지속되는 긴 호흡의 작업(Long-horizon)에서는 Claude 시리즈가 가장 높은 점수를 받았습니다.
4. 얼마나 쓸 수 있나? : 요금제별 사용 한도 및 API 정책 (2026.02 기준)
제미나이 3.1 프로의 강력한 성능을 제대로 활용하기 위해서는 자신의 사용 목적(앱 vs 개발자 API)에 따른 '사용량 한도(Usage Limits)'와 '비용 구조'를 명확히 이해해야 합니다.
2026년 2월 최신 업데이트를 기준으로, 일반 사용자와 개발자를 위한 핵심 정책을 정리해 드립니다.
1. 일반 사용자: 제미나이 앱(App) 구독 플랜별 한도
일반 사용자가 웹이나 앱에서 사용할 때, 가장 눈여겨봐야 할 것은 '일반 질문'과 '사고(Thinking) 질문'의 쿼리 수가 분리되어 있다는 점입니다.
Free (Basic): 맛보기 체험
일일 질문 제한: 무료 사용자는 Gemini 3.1 Pro 모델에 대해 하루 약 2~3회 질문할 수 있습니다. 이 횟수를 초과하면 성능이 낮은 'Gemini Flash' 모델로 전환됩니다.
컨텍스트 윈도우: 32,000 토큰 (약 50페이지 분량)으로 제한되어 긴 문서 분석에는 한계가 있습니다.
AI Pro (월 $20): 실무자를 위한 표준
컨텍스트 윈도우: 100만 토큰으로 대폭 확장됩니다. 논문 수십 편을 한 번에 분석할 수 있습니다.
질문 한도: 일반 Pro 질문은 하루 100회, 심층 추론이 필요한 Thinking 질문은 하루 300회까지 제공됩니다.
이미지 생성: 하루 최대 1,000장까지 넉넉하게 생성할 수 있습니다.
AI Ultra (월 $250): 전문가를 위한 무제한급 자유
압도적 한도: 일반 Pro 질문 500회, Thinking 질문은 무려 1,500회까지 가능합니다.
에이전트 작업: 자율적으로 도구를 사용하는 에이전트 요청을 하루 200회까지 수행할 수 있으며, 동시에 3개의 에이전트 작업(Concurrent tasks)을 병렬로 돌릴 수 있는 멀티태스킹 권한이 부여됩니다.
| 구분 | 무료 (Basic) | AI Pro (월 $20) | AI Ultra (월 $250) |
|---|---|---|---|
| 3.1 Pro 질문 횟수 | 일 2~3회 (유동적) | 일 100회 | 일 500회 |
| Thinking 모델 | 기본 제공 (제한적) | 일 300회 | 일 1,500회 |
| 컨텍스트 창 | 32,000 토큰 | 100만 토큰 | 100만 토큰 |
| 에이전트 요청 | 미지원 | 미지원 | 일 200회 |
2. 개발자 및 기업: API / Vertex AI 종량제 정책
1. Gemini 3.1 Pro API 비용 (유료 티어)
유료 티어는 입력 데이터 양(컨텍스트 길이)에 따라 비용이 다릅니다. 가격은 이전 3.0 모델과 동일하게 유지되어 가성비가 높아졌습니다.
| 구분 | 20만 토큰 이하 컨텍스트 | 20만 토큰 초과 컨텍스트 |
|---|---|---|
| 입력 (100만 토큰당) | $2.00 | $4.00 |
| 출력 (100만 토큰당) | $12.00 | $18.00 |
추가 비용: 구글 검색 연동(Grounding) 기능은 월 5,000회까지 무료이며, 이후 1,000회당 $14가 부과됩니다. Vertex AI 가격 페이지
이미지 생성: Imagen 4 등을 통한 이미지 출력은 100만 토큰당 약 $120(4K 이미지 장당 약 $0.24) 수준입니다.
2. Google AI Studio 무료 사용량 (Free Tier)
개발자 테스트를 위한 무료 쿼터입니다. 무료 티어 사용 시 데이터가 모델 학습에 활용될 수 있습니다.
분당 요청 횟수 (RPM): 5 ~ 15회
분당 토큰 제한 (TPM): 100,000 ~ 250,000 토큰
일일 요청 제한 (RPD): 100 ~ 250회 (모델 및 서버 상황에 따라 유동적)
확실히 제미나이 웹에서 사용할 때보다 높은 사용량을 보여줍니다.
3. 놓치지 말아야 할 핵심 스펙: '64k 출력'의 의미
이번 업데이트에서 개발자들이 가장 환호하는 부분은 바로 출력 길이(Output Length)의 확장입니다.
최대 64,000 토큰 출력: 기존 AI 모델들은 긴 코드를 작성하다가 중간에 뚝 끊기는 '잘림(Truncation)' 현상이 빈번했습니다. 제미나이 3.1 프로는 한 번의 응답으로 최대 64,000 토큰까지 뱉어낼 수 있어, 방대한 전체 코드를 끊김 없이 한 번에 완성할 수 있습니다.
5. 제미나이 3.1 프로 직업 써보니...(솔직 사용 후기)
새로운 기술의 진가는 벤치마크 점수가 아닌 실무 현장에서 증명됩니다. 출시 직후, 전 세계적인 트래픽 폭주로 인해 구글 AI 스튜디오(Google AI Studio)에 일시적인 접속 불가 현상이 발생할 정도로 개발자들의 관심은 뜨거웠습니다. (참고: 크롬 브라우저 사용자 중 접속 오류를 겪고 계신다면, 브라우저 캐시를 완전히 삭제한 후 재접속하면 원활하게 이용할 수 있습니다.)
필자는 접속 문제를 해결한 후, 구글이 새롭게 선보인 에이전트 중심의 통합 개발 환경인 '구글 안티그래비티(Google Antigravity)'에서 제미나이 3.1 프로를 실무 코딩에 직접 실시해 보았습니다.
극명하게 체감되는 코딩 성능의 비약적 향상
가장 먼저 체감한 것은 코드의 안정성과 문맥 파악 능력이었습니다. 직전 세대인 제미나이 3.0 프로를 사용할 때 가장 뼈아팠던 단점은, 모델이 복잡한 문제에 직면했을 때 스스로 혼란에 빠져 이른바 '삽질'을 하며 멀쩡하게 작동하던 코드의 구조마저 망가뜨리는 현상이 종종 발생했다는 것입니다. (제 API를 테스트한다는 명목으로 인터넷에 공개하는 일까지 발생했었습니다.)
하지만 3.1 프로에서는 그러한 불안정성이 감소하였습니다. 클로드에는 미치지 못하지만, 이전보다 제 지시를 더 잘 이해하고 그에 따라 코딩을 진행하여 체감상 성능이 분명히 향상되었습니다. 특히 개발 막바지에 보안 이슈 점검을 요청했을 때, 스스로 점검을 수행하면서도 최적화까지 수행하는 모습이 매우 인상적이었습니다.
한계점: 여전한 무한 루프 교착
물론 아쉬운 순간도 있었습니다. 복잡한 로직을 처리하던 중, 작동하지 않는 잘못된 해결책을 계속해서 반복 시도하며 아까운 토큰만 소모하는 '무한 루프(Infinite Loop)' 현상에 빠지는 경우가 여러차례 발생했습니다.
흥미로운 점은, 이 교착 상태에 빠진 코드를 앤트로픽의 클로드(Claude)에게 넘겨주자 단번에 문제를 파악하고 올바른 해결책을 제시했다는 점입니다. 이는 제미나이 3.1 프로가 훌륭한 도약을 이뤄냈음에도 불구하고, 고도로 특화된 특정 코딩 영역이나 장기적인 호라이즌(Long-horizon) 과제에서는 여전히 클로드가 강력한 방어벽을 구축하고 있음을 현장에서 직접 확인한 사례였습니다.
글쓰기 감성
의외의 발견은 '글쓰기' 능력이었습니다. 3.1 프로는 논리적이고 정제된 글을 잘 쓰지만, 창의적이고 자유분방한 글쓰기 맛은 오히려 이전 모델인 3.0이 더 낫게 느껴지기도 했습니다. 너무 똑똑해져서 감성이 살짝 줄어든 느낌이랄까요?
총평
결론적으로, 최근 폼이 다소 떨어져 아쉬움을 남겼던 3.0 버전에 비해 제미나이 3.1 프로는 확연히 훌륭하고 안정적인 도약을 이뤄냈습니다. 비록 클로드라는 거대한 산이 여전히 버티고 있지만, 이번 0.1 업데이트가 보여준 파괴력을 경험하고 나니, 향후 풀체인지되어 등장할 ‘제미나이 3.5’에 대한 기대감이 한층 고조되었습니다.
6. 결론: 구글의 강력한 반격, 그러나 남겨진 숙제
구글 제미나이 3.1 프로는 단순한 언어 모델의 버전업이 아닙니다. 인간의 명시적 지시를 따르는 '수동적 도구'에서, 인간의 추상적인 의도를 스스로 해석해 계획을 짜고 능동적으로 실행하는 '자율적 파트너'로의 진화를 상징합니다. 77.1%라는 파괴적인 ARC-AGI-2 점수는 이를 뒷받침하는 명백한 증거입니다.
물론 순수 코딩(Codex)과 장기 계획 신뢰성(Claude) 측면에서 경쟁사들의 위협은 여전히 강력합니다. 그러나 구글은 100만 토큰의 네이티브 멀티모달 윈도우와 전용 엔드포인트, 그리고 타사 모델까지 품어버린 혁신적인 안티그래비티 IDE 생태계를 통해 이 간극을 전략적으로 상쇄해 냈습니다.
물론 완벽하진 않았습니다. 복잡하게 얽힌 코딩 문제(무한 루프) 해결 능력은 여전히 경쟁자인 클로드(Claude)가 한 수 위였으며, 너무 논리 정연해진 탓인지 글쓰기 특유의 창의적 감성은 이전 모델(3.0)보다 다소 건조하게 느껴졌습니다.
하지만 이번 업데이트가 보여준 파괴력은 충분했습니다. 학술 및 추론 영역을 제패한 구글이 칼을 갈고 준비 중인 차기작 ‘제미나이 3.5’가 더욱 기다려지는 이유입니다.
[참고 문헌 및 출처]
Google Cloud Blog: Gemini 3.1 Pro on Vertex AI / Enterprise
Google Blog: Gemini 3.1 Pro / Vibe Coding / Gemini 3 Flash / Google AI Ultra
Google AI for Developers: Preview, Rate Limits, Pricing
Google Antigravity Blog / Official Pricing
DeepMind Model Card: Gemini 3.1 Pro
Artificial Analysis: AI Models Comparison
Reddit: /r/Bard, /r/OpenAI, /r/accelerate 등 전문가 현장 벤치마크 및 비교
기타 IT 전문 매체: TechCrunch, 9to5Google, Mashable, ZDNet, SiliconANGLE 보도 종합
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.